DeepSeek и Gemma: как эксперимент с гибридной LLM на Kaggle сломал библиотеку Transformers
На Kaggle попробовали почти невозможное: взять 31B-веса Gemma, пересадить их в MoE-каркас DeepSeek и запустить гибрид без дообучения. Ради этого пришлось патчить Transformers, обходить сбой инициализации 4-битных весов и вручную искать спрятанных экспертов. Итог — модель говорит бессвязно, но сам эксперимент показывает, насколько далеко можно зайти с PyTorch, Hugging Face и набором хаков.
AI-обработка оригинала Habr AI; редакция Hamidun News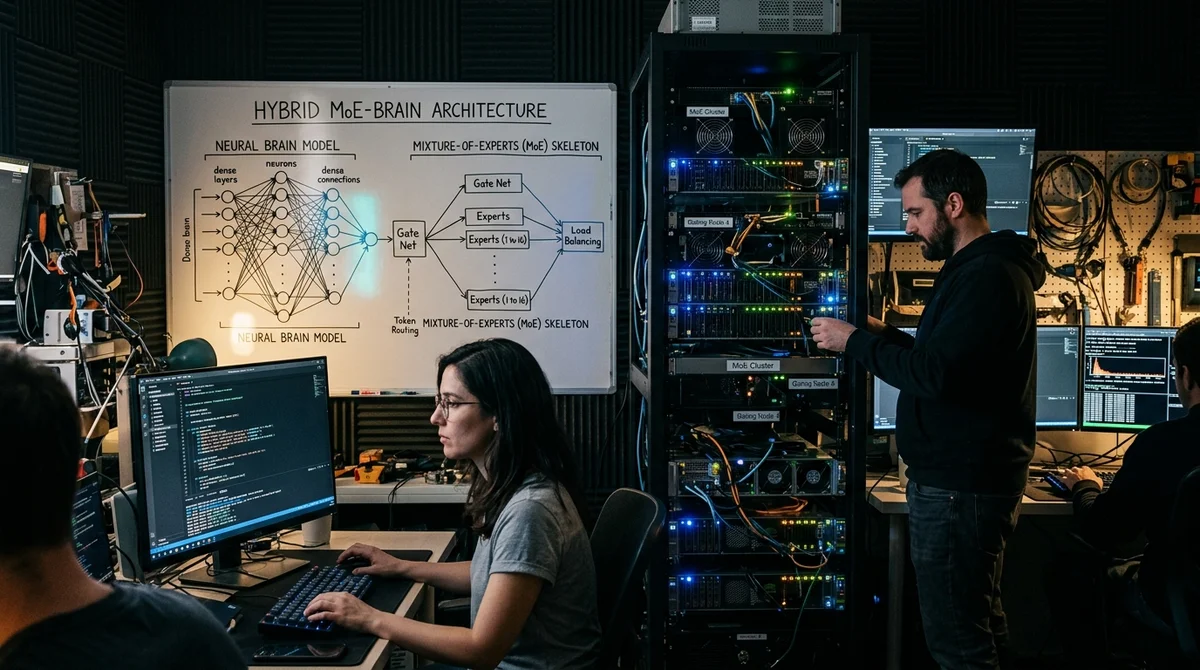
Энтузиасты собрали гибридную LLM почти против правил: взяли четыре слоя 31B-модели Gemma и встроили их в пустую MoE-архитектуру DeepSeek-V4 без дообучения. Рабочего конкурента ChatGPT из этого не вышло, но сам процесс показал, насколько глубоко можно переломать PyTorch и Transformers ради проверки экстремальной идеи.
Зачем нужен гибрид Идея родилась из предельно жёстких ограничений: две бесплатные T4 в
Kaggle, около 30 ГБ RAM и никакого бюджета на полноценный fine-tuning. Вместо обучения авторы решили проверить более грубый сценарий — структурное сращивание моделей. В роли донора выступила Gemma-4-31B, ужатая до 4-битного NF4-формата, а в роли «скелета» — пустая DeepSeek-V4 с роутером Mixture-of-Experts.
Задача звучала почти как мем: пересадить часть весов из одной архитектуры в другую и посмотреть, удастся ли химеру вообще оживить. С инженерной точки зрения проект был интересен не качеством ответа, а самим фактом совместимости. У Gemma и DeepSeek разные размерности, своя логика нормализации, разные блоки attention и собственные правила роутинга токенов между экспертами.
В учебниках такой перенос обычно относят к невозможным без промежуточных проекций и дообучения. Авторы сознательно пошли против этого правила и поставили эксперимент на выживание библиотек: что сломается первым — модель, память Kaggle или сам стек Hugging Face.
Где всё разваливалось Первый сбой начался ещё на этапе загрузки.
Transformers отказалась нормально распознавать кастомный тип gemma4, а затем рухнула с ошибкой dict.to_dict(), потому что один из внутренних модулей сериализовал конфиг в обычный словарь и тут же попытался обращаться к нему как к объекту. Чтобы пройти дальше, авторы зарегистрировали тип вручную в CONFIG_MAPPING и дописали monkey patch для GenerationConfig, который на лету оборачивает словарь в прокси-объект.
Иначе вся операция заканчивалась ещё до создания гибрида. Следом библиотека попыталась инициализировать пустые участки DeepSeek случайным шумом, вызвав normal_. На этом месте PyTorch выдал NotImplementedError: донорские веса были загружены через bitsandbytes в 4-битном виде и хранились как uint8, а генератор нормального распределения работает с float-тензорами.
Проблему решили максимально прямолинейно — перехватили TORCH_INIT_FUNCTIONS["normal_"] и запретили функции трогать байтовые тензоры. Это не красивый фикс, а именно хирургический обход, но без него пересадка даже не стартовала. Самой неприятной частью оказались эксперты DeepSeek и память.
MoE-блоки были спрятаны не в обычном ModuleList, а внутри кастомного класса, по которому нельзя просто пройтись циклом. Кроме того, распаковка 31B-слоя Gemma в оперативной памяти Kaggle почти мгновенно приводила к OOM. Для обхода авторы написали рекурсивный «сонар», который ищет нужные подслои по атрибутам gate_proj, up_proj и down_proj, а перенос весов делали микро-порциями через CPU, разнося модели по двум GPU и постоянно вызывая сборщик мусора.
«В машинном обучении нет непробиваемых стен архитектуры».
Как сшили модель Финальный скрипт свёл всю операцию в последовательность жёстких патчей и копирования весов.
Для каждого из четырёх слоёв он подбирал матрицы под размер целевого слоя, при необходимости дополняя их нулями, отдельно пересаживал attention-проекции и отдельно — MLP-компоненты у каждого найденного эксперта. После каждого крупного копирования память сразу чистилась. Уже после трансплантации авторам пришлось ещё и переписать роутер MoE, чтобы во время инференса модель не падала на конфликте размерностей и могла выдать хоть какой-то текст.
Ключевые технические шаги были такими: Регистрация кастомного конфига Gemma в глобальном реестре Transformers Monkey patch для GenerationConfig, переживающий ошибку dict.to_dict() Блокировка normal_ для 4-битных uint8-весов Рекурсивный поиск экспертов и перенос матриц микро-порциями через CPU Проверка получившейся химеры показала ожидаемый результат: модель действительно запустилась, но генерировала бессвязный текст, смесь случайных токенов и обрывков фраз. Для авторов это всё равно считалось успехом, потому что цель была не в качестве ответов, а в демонстрации принципа.
Они не согласовывали словари, не обучали переходные проекции и не делали fine-tuning после пересадки, поэтому хаотичный поток токенов на выходе был почти неизбежен. Зато эксперимент доказал, что архитектурные ограничения часто оказываются не стеной, а длинным списком низкоуровневых проблем, которые можно обойти кодом.
Что это значит Такие эксперименты не создают готовый продукт, но хорошо показывают границы
современных open-source LLM. Если веса, квантование, роутинг и hidden states можно хотя бы частично состыковать без дообучения, то дальше открывается простор для более практичных гибридов — уже с нормальными проекциями, адаптацией словаря и последующей настройкой. Для разработчиков это сигнал: стек вокруг моделей всё ещё хрупок, а значит пространство для нестандартных сборок только растёт.
- 12 нояб. 2026 г.Сотрудник Railway запустил ИИ-агента на DeepSeek, и тот полез в инфраструктуру конкурента
- 12 нояб. 2026 г.Новичок написал Go-бота для собеседований: голос, 860 вопросов и 25–35 МБ памяти
- 12 нояб. 2026 г.Artificial Analysis выявила потери качества у 24 из 103 API-эндпоинтов
- 12 нояб. 2026 г.NaiveAI сократила медианное время ответа до 3,1 секунды в тесте Latent Space
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.