Apple делает ставку не на гигантские модели, а на локальный ИИ в чипах серии M
Apple всё чаще называют проигравшей в AI-гонке, но у компании может быть другая ставка — не на обучение гигантских моделей, а на дешёвый локальный инференс. Смысл в чипах серии M: общая память для CPU, GPU и Neural Engine снижает потери на перенос данных и делает запуск моделей на устройстве более практичным для бизнеса и edge-сценариев.
AI-обработка оригинала Habr AI; редакция Hamidun News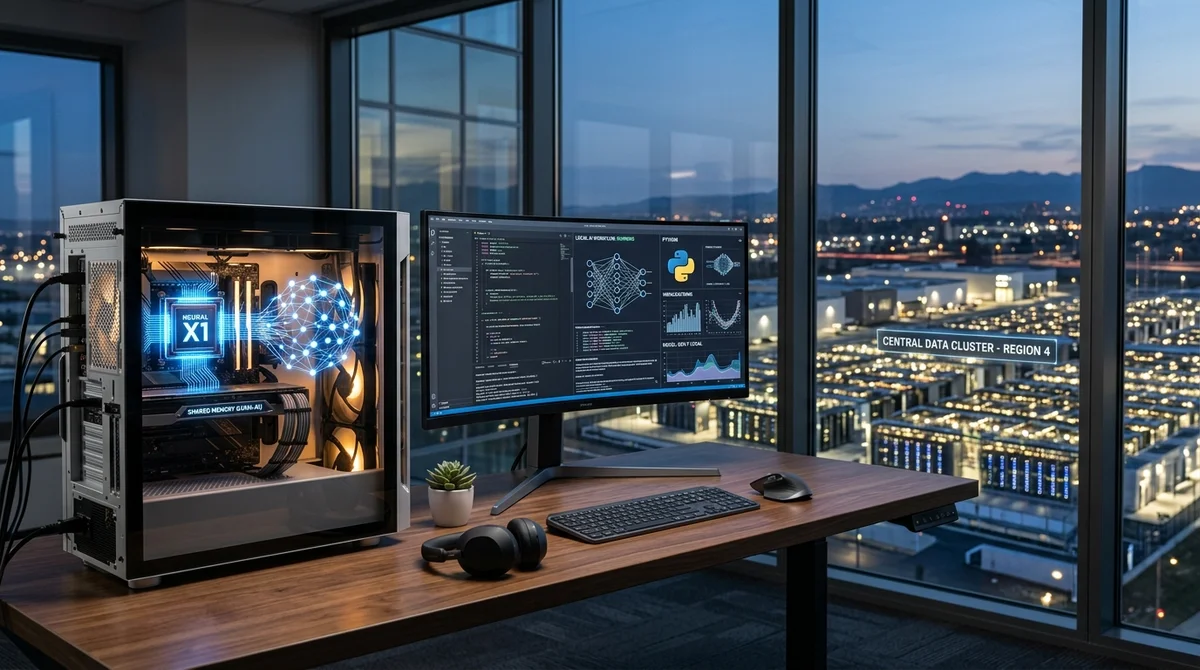
Apple редко фигурирует в заголовках про ИИ так же громко, как OpenAI, Google или NVIDIA. Но тезис о том, что компания проиграла гонку, может быть слишком узким: Apple делает ставку не на самые большие модели, а на то, чтобы инференс работал локально, экономно и без постоянной привязки к облаку.
Не та метрика Когда рынок обсуждает ИИ, разговор почти всегда сводится к одному и тому же
набору символов статуса: сколько у компании GPU, какого размера дата-центры, во сколько обошёлся новый тренировочный прогон и может ли модель обогнать конкурентов в бенчмарках. На этом фоне Apple действительно выглядит странно. Siri давно стала удобной мишенью для шуток, собственная большая модель не доминирует в новостях, а интеграции с внешними системами воспринимаются скорее как догоняющий шаг. Но в этом и состоит главный тезис материала: Apple может участвовать не в гонке за самую большую модель, а в гонке за самый практичный способ использования ИИ. Если смотреть не на обучение, а на инференс, картина меняется. Важным становится не размер кластера, а то, насколько быстро, дёшево и стабильно модель можно запустить рядом с пользователем — на ноутбуке, рабочей станции или другом локальном устройстве.
Ставка на чипы Ключевой аргумент здесь — архитектура Apple Silicon.
В обычной схеме CPU и GPU работают с разными пулами памяти, и данные приходится постоянно гонять между ними. Это создаёт лишние задержки, тратит энергию и упирается в пропускную способность шины. В чипах серии M Apple использует унифицированную память: CPU, GPU и Neural Engine работают с одним общим пространством. За счёт этого уменьшается число лишних копирований и сама система лучше подходит для задач инференса.
- CPU, GPU и Neural Engine обращаются к общей памяти без постоянного копирования данных Меньше потерь на передачу между вычислительными блоками и ниже энергозатраты Локальный запуск моделей становится реалистичнее для повседневных задач * ИИ-нагрузки можно переносить ближе к пользователю, а не только в облако Отдельно автор выделяет Neural Engine — специализированный блок, заточенный под тензорные операции, на которых держится современный ИИ. Логика простая: если инференс — это не универсальные вычисления, а в основном повторяющиеся матричные операции, то эффективнее дать им отдельное «железо», а не пытаться решать всё только силами CPU или GPU. В этой логике Apple не копирует подход NVIDIA для дата-центров, а строит более компактную и прикладную инфраструктуру на стороне устройства.
Где это полезно Практический смысл такого подхода особенно заметен там, где важны цена,
задержка и энергопотребление. Это может быть edge-развёртывание, автоматизация бэк-офиса, локальная обработка данных, сценарии с требованиями к приватности или рабочие процессы, где нет смысла постоянно отправлять каждый запрос в облако. Да, облачный H100-кластер даст более высокую пиковую производительность. Но для многих реальных задач бизнесу нужен не рекорд, а предсказуемая экономика и возможность держать систему под рукой. У этого подхода есть и границы. Apple Silicon не отменяет дата-центры и не делает ненужным обучение крупных моделей на огромных GPU-кластерах. Если нужно тренировать frontier-модели или обслуживать миллионы одновременных пользователей, облачная инфраструктура никуда не исчезает. Речь о другом: значимая часть ИИ-рынка находится не в обучении, а в применении уже готовых моделей, и именно здесь локальный инференс может оказаться сильной стороной Apple.
«Это не проигрыш в гонке.
Это участие в совершенно другой гонке.»
Что это значит Главная мысль проста:
Apple не обязана побеждать NVIDIA или OpenAI по их правилам, чтобы занять важное место в AI-экосистеме. Если рынок действительно сместится от демонстрации мощности к окупаемому внедрению, преимущество получат те, кто умеет запускать модели ближе к пользователю, дешевле и с меньшими издержками. Для разработчиков и компаний это выглядит не как хайп, а как рабочая инфраструктура. И в такой версии гонки у Apple действительно есть сильная позиция.
- 12 нояб. 2026 г.Google привезла Gemini Intelligence в Android Auto — пока только для Pixel
- 12 нояб. 2026 г.Adobe показала на Max четыре ИИ-прототипа: 3D из фото, звук-квадрат и копипаст правок
- 12 нояб. 2026 г.Apple продаёт ИИ сверх лимита: в Logic Pro появился пакет за $50 без подписки
- 12 нояб. 2026 г.Apple продаёт пакеты ИИ-лимитов за $50 разово — и обходит подписочную модель
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.