Baidu выпустила Qianfan-OCR — 4B-модель для распознавания и понимания документов
Baidu показала Qianfan-OCR — 4B-модель, которая объединяет OCR, анализ вёрстки и понимание документов в одной архитектуре. Вместо многошагового пайплайна система сразу переводит изображение в Markdown и поддерживает задачи по промпту: например, извлечение таблиц, ответы на вопросы по документу и автоматизацию внутренних процессов. Это ещё один шаг к умным документным AI-сервисам для бизнеса.
AI-обработка оригинала MarkTechPost; редакция Hamidun News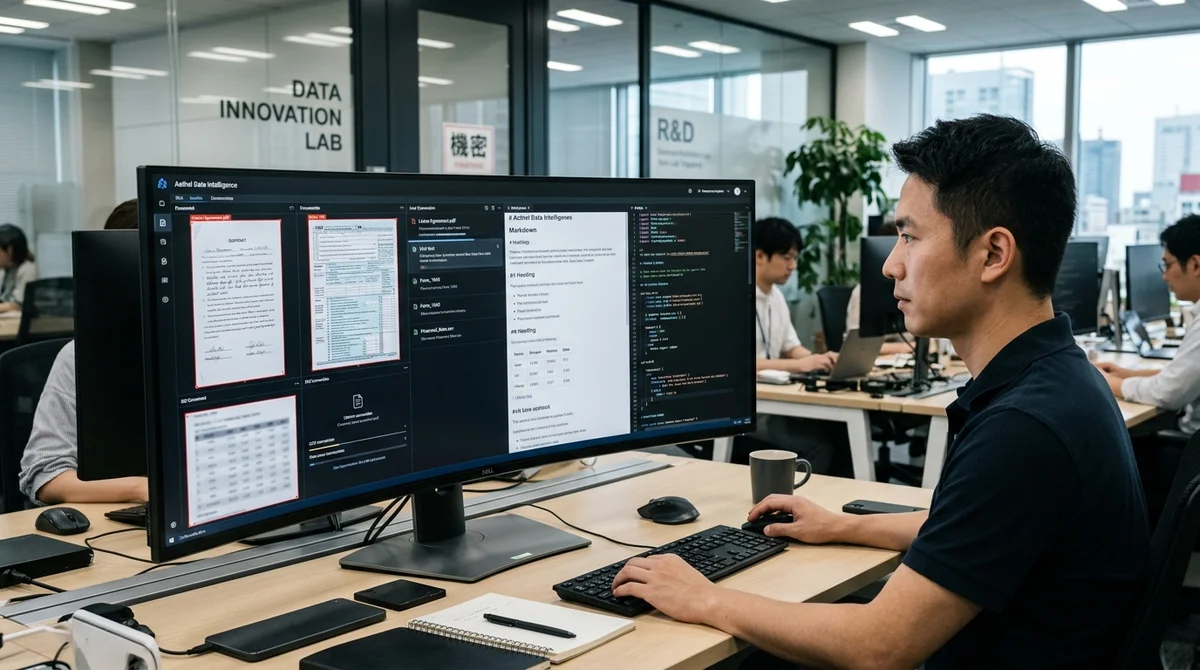
Baidu представила Qianfan-OCR — унифицированную 4B-модель для работы с документами, которая объединяет распознавание текста, анализ структуры и понимание содержимого. Вместо классического OCR-конвейера из нескольких этапов система сразу превращает изображение документа в структурированный Markdown и умеет выполнять задачи по запросу пользователя.
Почему рынок уходит от OCR-конвейеров
Классические OCR-системы обычно собираются из нескольких независимых блоков: один ищет области на странице, другой распознаёт текст, третий пытается понять таблицы, заголовки и порядок чтения. Такой подход работает, пока документ простой, но начинает ломаться на сложной вёрстке, сканах, формах, смешанном контенте, нестандартных макетах и многостраничных файлах. Чем больше шагов в цепочке, тем выше риск, что ошибка на раннем этапе испортит весь результат.
На этом фоне Baidu Qianfan делает ставку на единый vision-language подход. Qianfan-OCR должна не просто считывать символы, а воспринимать документ как цельный объект: с блоками, структурой, логикой и смыслом. Для компаний это важный сдвиг, потому что бизнесу обычно нужен не текст сам по себе, а готовые данные, с которыми можно дальше работать в поиске, аналитике, автоматизации и внутренних AI-сценариях, включая production-процессы.
Что умеет Qianfan-OCR По описанию команды, это end-to-end модель на 4 млрд параметров, которая
объединяет разбор документа, layout analysis и document understanding в одной архитектуре. Главное отличие от привычного OCR в том, что модель не опирается на длинный набор последовательно соединённых модулей. Вместо этого она получает изображение на вход и сразу выдаёт структурированный результат, включая преобразование image-to-Markdown.
Это сокращает число промежуточных преобразований существенно. Отдельно выделяется prompt-driven логика. То есть модель можно использовать не только для базового распознавания, но и для прикладных задач, когда пользователь формулирует, что именно нужно извлечь из документа.
В статье прямо упоминаются сценарии с извлечением таблиц и ответами на вопросы по документу. Это приближает OCR не к архивному инструменту для сканов, а к интерфейсу работы с корпоративными файлами в рабочих пайплайнах компаний. Формат Markdown здесь тоже важен.
Для команд, которые строят базы знаний, AI-поиск или пайплайны для LLM, недостаточно просто получить текст без структуры. Нужны заголовки, списки, таблицы и логичный порядок блоков. Если модель сразу отдаёт документ в удобном для машинной обработки виде, это сокращает объём постобработки и делает результат пригоднее для автоматической индексации, суммаризации и последующего вопросно-ответного слоя.
Для интеграции это заметный плюс.
- Прямое преобразование изображения документа в Markdown Анализ структуры страницы без отдельного пайплайна из нескольких модулей Извлечение таблиц по запросу пользователя Ответы на вопросы по содержимому документа Единая модель вместо набора разрозненных компонентов ## Где это пригодится Практический смысл таких моделей в том, что они сокращают число промежуточных операций между документом и полезным действием. Если система действительно стабильно понимает layout, текст и смысл в одном проходе, это упрощает обработку договоров, инструкций, отчётов, анкет, презентаций и внутренних баз знаний. Особенно это актуально для команд, которые хотят автоматически переводить PDF и сканы в формат, пригодный для RAG, поиска по знаниям или последующего анализа LLM. Для разработчиков и продуктовых команд важен ещё один момент: унификация снижает инженерную сложность. Вместо поддержки нескольких OCR- и post-processing-сервисов можно строить более короткий стек. Это не гарантирует идеальное качество на каждом типе документа, но направление понятно: рынок движется от набора специализированных детекторов к крупным моделям, которые работают с документом как с мультимодальным объектом и сразу готовят его для downstream-задач, а также быстрее запускают новые сценарии.
Что это значит Qianfan-OCR показывает, что OCR быстро превращается из узкой технологии
распознавания символов в слой документного интеллекта. Если такие модели подтвердят качество в реальных сценариях, компаниям будет проще автоматизировать работу с документами без сложных многоэтапных пайплайнов и ручной сборки отдельных компонентов. Выиграют прежде всего те команды, которым нужен быстрый переход от PDF и сканов к данным, готовым для поиска, аналитики и AI-ассистентов.
- 12 нояб. 2026 г.Baidu выпустила ERNIE 5.5 Flash Preview: 280B параметров, 14B активных, 1M контекста
- 3 февр. 2026 г.Baidu OpenClaw: китайский гигант упрощает жизнь разработчикам (пока бесплатно)
- 29 окт. 2026 г.Baidu выпустила Unlimited-OCR 2: OCR ускорился до 7 раз на 100 страницах
- 2 июл. 2026 г.PaddleOCR выпустила PP-OCRv6: распознавание текста на 50 языках от 1,5 до 34,5 млн параметров
От чтения про ИИ-агентов — к запуску своего агента за вечер
Пошаговая сборка автономных агентов и MCP-связок в Hamidun Academy (academy.hamidun.com) (72 часа бесплатно) или мгновенный запуск готовых мультишаговых агентов в облаке Nomad.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.