Как измерить работу AI-агента в QA: история одного бенчмарка
Михаил Федоров собрал объективный бенчмарк для QA Assist — системы из 11 AI-агентов, которые автоматизируют тестирование. Вместо субъективной оценки работы агента теперь можно честно сравнивать версии, отдельные улучшения и эксперименты с разными моделями LLM. Весь проект и артефакты пайплайна выложены в открытом доступе.
AI-обработка оригинала Habr AI; редакция Hamidun News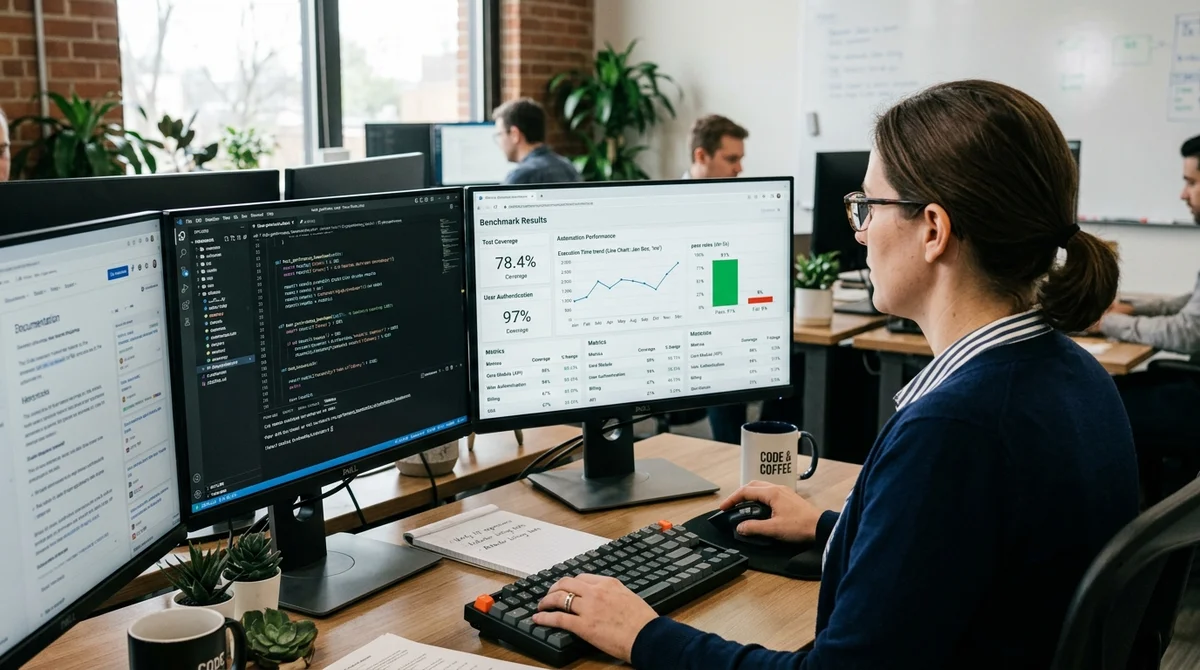
Когда AI-агент работает на задачах тестирования, главный вопрос становится больной: действительно ли он лучше, чем вчера? На этот вопрос нельзя ответить просто так — нужны цифры. Михаил Федоров, разработчик QA Assist, столкнулся с этой проблемой в полный рост. QA Assist — это система из 11 AI-агентов, которые вместе покрывают весь цикл тестирования: от декомпозиции требований до готовых автотестов. Но как оценить, улучшилась ли система после очередного обновления? На глаз — ненадёжно.
Почему оценки на глаз не работают Субъективная оценка может быть где угодно: агент вчера нашёл
5 багов, сегодня — 7, но можете ли вы быть уверены, что улучшилась именно система, а не просто изменился тестовый набор? Разные версии модели, разные промпты, разные параметры температуры LLM — всё это влияет на результат. Без систематического бенчмарка сложно разобраться, что именно помогает. Федоров решил проблему радикально: собрал отдельный проект-бенчмарк, на котором агент работает по одинаковым правилам, на одинаковых требованиях, с одинаковыми граничными случаями.
Что умеет делать бенчмарк Сравнивать разные версии агента на одном наборе данных
Тестировать влияние отдельных улучшений пайплайна (prompt-engineering, изменения в логике декомпозиции) Экспериментировать с моделями: GPT-5.5 vs Claude vs другие Отслеживать прогресс со временем с визуализацией улучшений * Генерировать полный отчёт о проценте найденных багов, пропусков и ложных срабатываний Важно: бенчмарк не означает «идеальный тестовый набор». Это означает контролируемый тестовый набор, где переменных как можно меньше, и каждый прогон воспроизводим.
Артефакты в одном прогоне За каждый запуск агент подготавливает полный пакет — выписанные
требования и их декомпозиция, тест-сценарии с шагами, готовый код автотестов, отчёт о покрытии и пропусках, лог принятых и отклонённых решений. Все артефакты хранятся в публичном репо, можно посмотреть, как агент рассуждает на разных примерах. Это полезно не только для учёта прогресса, но и для отладки: когда агент ошибается, видно, на каком шаге пайплайна и почему.
Что это значит Для разработчиков QA-инструментов бенчмарки становятся обязательным — это
единственный способ быть честным с собой о качестве работы. Открытый доступ к проекту Федорова показывает, что такая прозрачность возможна. Другие команды, работающие с AI-агентами в тестировании, теперь знают, что нужно делать с самого начала.
- 12 нояб. 2026 г.Дженсен Хуанг ушёл с поста CEO Nvidia: компания потеряла $1,4 трлн за две недели
- 12 нояб. 2026 г.Claude in Chrome требует разрешать каждый клик на сайтах с категорией 3
- 12 нояб. 2026 г.AWS Quick получил шесть агентов для продактов: от жалоб клиентов до спеки
- 12 нояб. 2026 г.Anthropic с 12 ноября закрывает Claude для компаний России, даже с юрлицом за рубежом
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.