Почему боты на базе защищённых LLM часто взламываются: анализ 14 тысяч GPT
Базовые LLM защищены от атак. Но боты, построенные на их основе, уязвимы. Виновник — orchestration layer: system prompts, RAG, tools, webhooks. Анализ 14 904 кастомных GPT показал, что именно эта слоистая архитектура становится слабым местом для хакеров.
AI-обработка оригинала Habr AI; редакция Hamidun News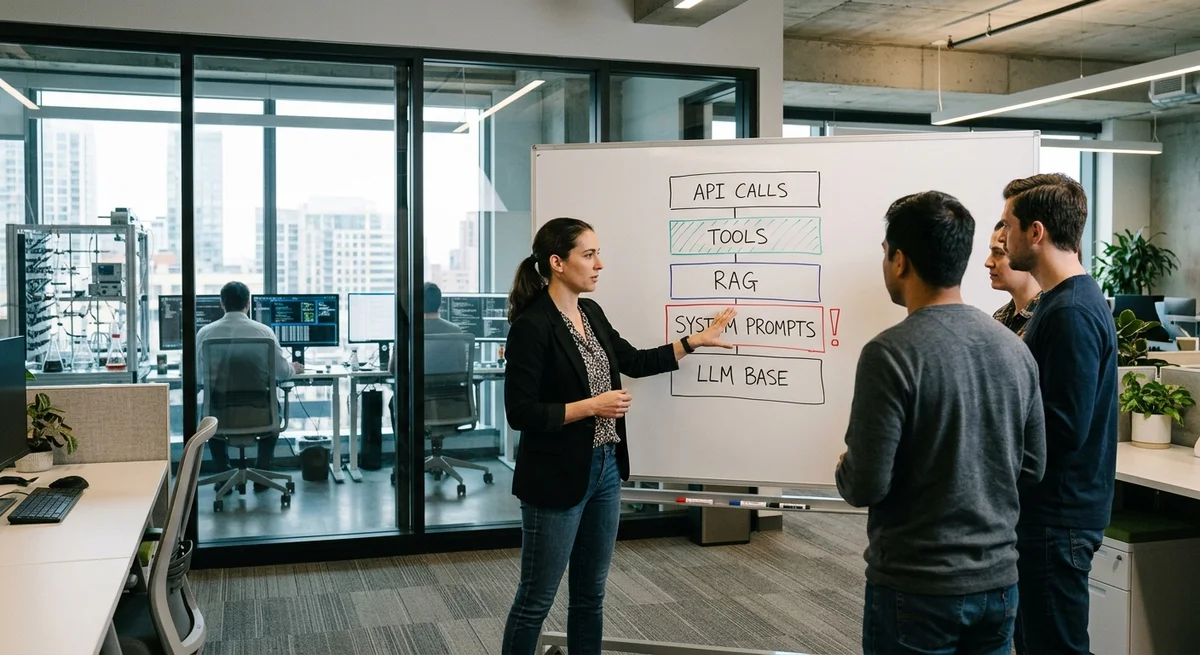
Безопасная базовая LLM-модель — не гарантия безопасного бота. Парадокс? Нет, просто архитектура. Когда вы берёте защищённую модель типа GPT или Claude и обвёртываете её в system prompt, добавляете RAG, tools и API — появляется новый attack surface. Это называют orchestration layer, и именно здесь взламывают боты, которые защищаются на уровне модели.
Как защищена база Базовые LLM проходят серьёзный safety-training: авторы обучают их
отказываться от опасных запросов. Команда OpenAI, Anthropic и других тратит месяцы на то, чтобы модель понимала, какие просьбы небезопасны. Поверх этого идёт RLHF (reinforcement learning from human feedback) — модель выравнивается с человеческими предпочтениями о том, что этично, а что нет. Результат: если вы напрямую запросите GPT взломать сайт или выдать личные данные, она откажется.
Где начинаются проблемы Но как только вы оборачиваете модель в бота (будь то
Telegram-бот, веб-приложение или AI-агент), добавляется целый пласт компонентов, каждый из которых потенциально небезопасен: System prompts — инструкции боту, которые иногда переопределяют обучение модели и могут быть инжектированы Память диалога — история запросов, которая растёт и может быть использована для контекстной атаки RAG (Retrieval-Augmented Generation) — внешние БД и документы, которые можно заравнить ложными данными Tools и функциональные вызовы — прямой доступ к API, почте, БД, платёжным системам * Webhook-логика и внешние сервисы — недоверчивые источники данных, которые могут быть скомпрометированы Каждый слой добавляет новый вектор атаки. System prompt может быть инжекционирован через user input. Память диалога может быть загромождена prompt injection-паттернами.
RAG может вернуть отравленные данные из скомпрометированного источника. Tools могут быть использованы для обхода ограничений модели.
Что показал анализ Исследователи из arxiv провели анализ 14 904 кастомных GPT — публичных
агентов, созданных пользователями на платформе OpenAI. Результат: подавляющее большинство уязвимо для базовых атак на orchestration layer. Атакующему не нужно взламывать саму модель — достаточно инжектировать system prompt или отравить RAG-источник.
Большинство уязвимостей находятся не в модели, а в том, как её оборачивают.
Это значит, что вы можете использовать самую безопасную LLM на планете, но неправильная архитектура сведёт её преимущества на нет. Боты слабеют в масштабировании, потому что каждый новый компонент добавляет сложность и новые точки входа.
Что это значит Безопасность AI-бота — это не только выбор модели, это всесторонняя архитектурная задача.
Нужно защищать system prompts от инъекций, валидировать входные данные, контролировать RAG-источники, ограничивать права tools, логировать все действия. Иначе красивая LLM становится красивой дырой в безопасности.
- 12 нояб. 2026 г.Дженсен Хуанг ушёл с поста CEO Nvidia: компания потеряла $1,4 трлн за две недели
- 12 нояб. 2026 г.Профсоюз Окленда добился переобучения вместо увольнений из-за ИИ: за забастовку 94,1%
- 12 нояб. 2026 г.Восемь стран и OpenAI с Anthropic обещают «рубильник» для ИИ-моделей, но без сроков и штрафов
- 12 нояб. 2026 г.OpenAI и ModRetro выпустили консоль за $200 для игр, написанных в Codex
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.