#Железо
Подборка материалов по теме «Железо»: релизы, исследования, бенчмарки, опенсорс.


Whisper и Faster-Whisper: как расшифровывать аудио локально без отправки файлов в облако
Пошаговый разбор локальной транскрибации аудио через Faster-Whisper и Python: данные не уходят в облако, а запуск возможен офлайн как на CPU, так и на GPU.
Nvidia выпустила Nemotron 3 Nano Omni — открытую мультимодальную модель для edge-агентов
Nvidia представила Nemotron 3 Nano Omni — открытую мультимодальную модель с 30 млрд параметров и 3 млрд активных на инференсе, рассчитанную на автономных AI-агентов…
OpenAI не дотянула до внутренних целей роста, и рынок списал десятки миллиардов
После сообщения о том, что OpenAI не выполнила внутренние цели по выручке и росту ChatGPT, инвесторы резко продавали акции партнёров компании — от Oracle до…
NVIDIA на GTC 2026 сместила фокус с чипов на фабрики токенов и эру Agent-as-a-Service
OpenAI, MiniMax и Nvidia задали тон марту в ИИ: Sora, GPT-5.4 и ставка на Миру Мурати
Глава Anthropic Дарио Амодей обещает «хороший ИИ», но критики требуют замедлить гонку
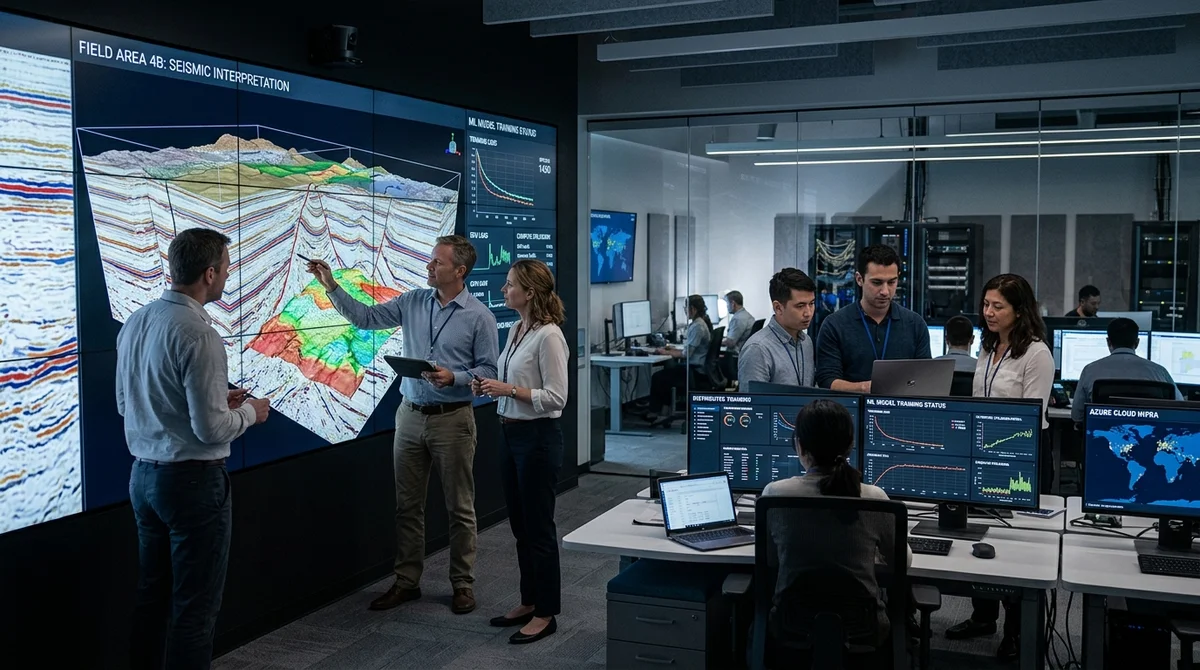
Как TGS и AWS сократили обучение сейсмической ИИ-модели с полугода до пяти дней
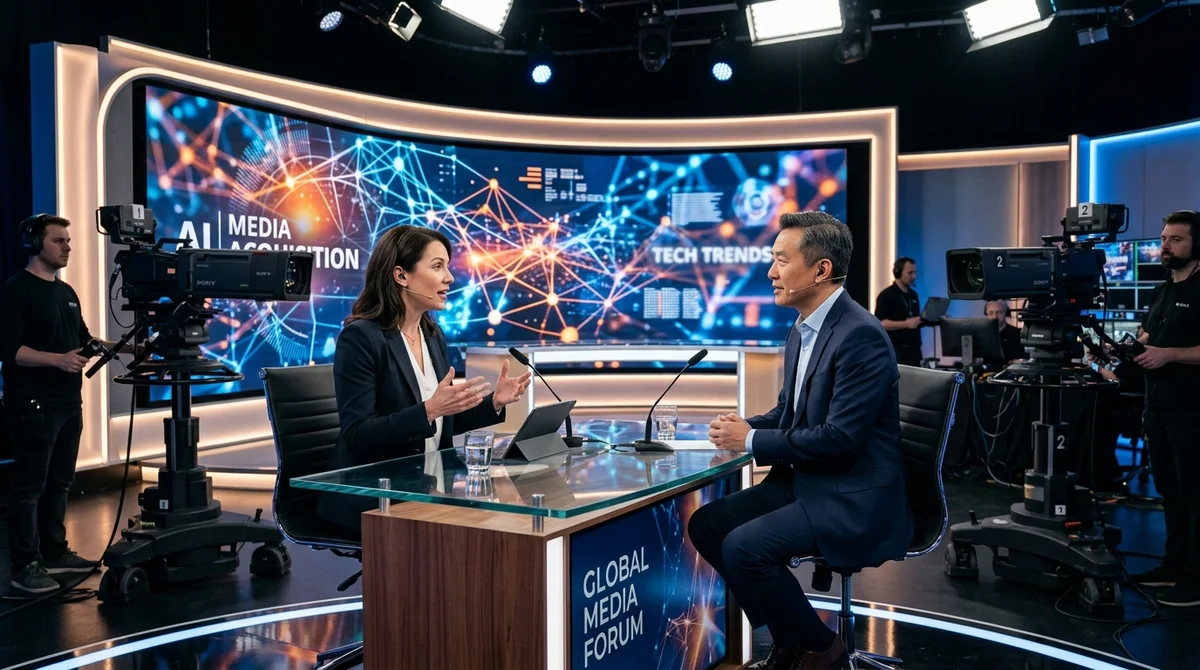
OpenAI купила техношоу TBPN, чтобы сильнее влиять на публичный разговор об ИИ
OpenAI выходит в медиа и покупает популярное в Кремниевой долине шоу TBPN, обещая сохранить редакционную независимость проекта и использовать его для открытого…
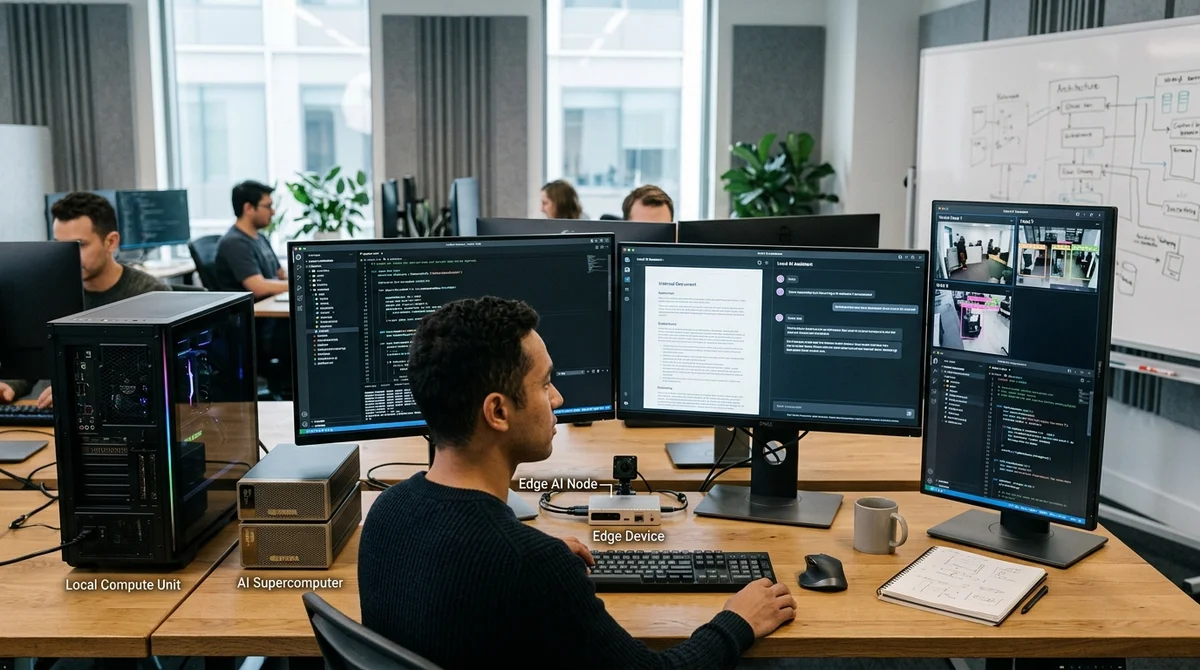
Google Gemma 4, NVIDIA и OpenClaw: локальные AI-агенты без оплаты за каждый токен
Google и NVIDIA продвигают локальный запуск Gemma 4 на RTX, Jetson и DGX Spark, чтобы всегда активные AI-агенты вроде OpenClaw работали быстрее, дешевле и без…
OpenAI покупает ток-шоу TBPN за сотни миллионов долларов и выходит в медиа

OpenAI покупает техшоу TBPN: это первая медийная сделка компании в истории
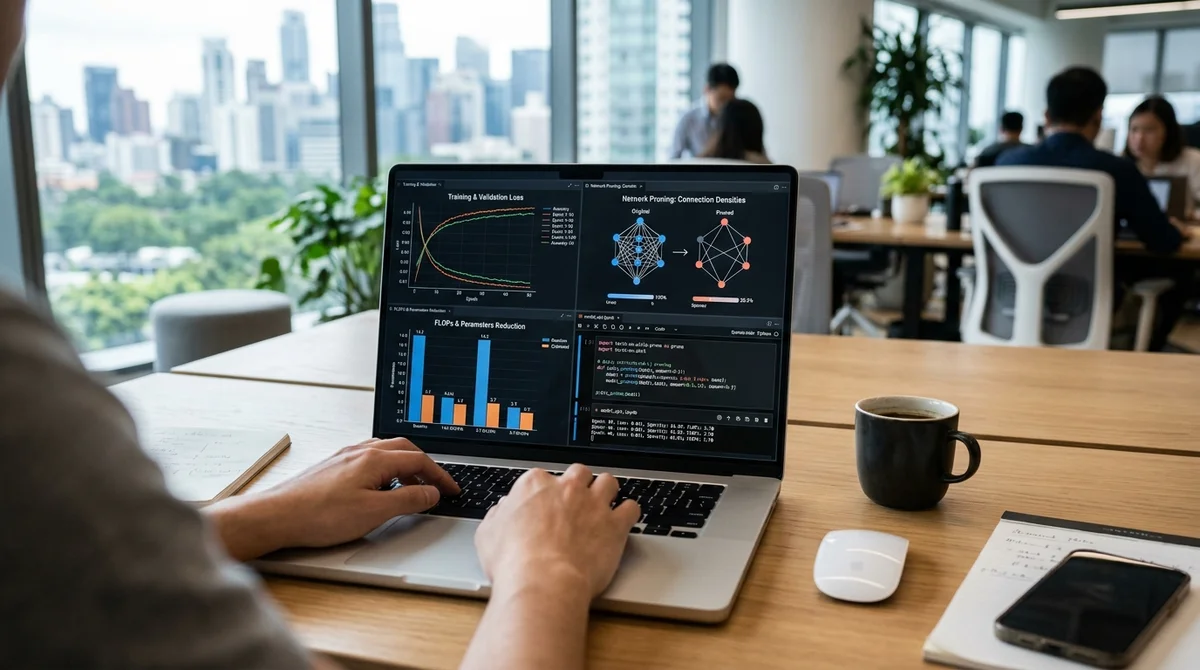
NVIDIA показала полный пайплайн оптимизации модели с FastNAS pruning и fine-tuning
Qwen и llama.cpp: как запустить локальную нейросеть без облака на компьютере или сервере
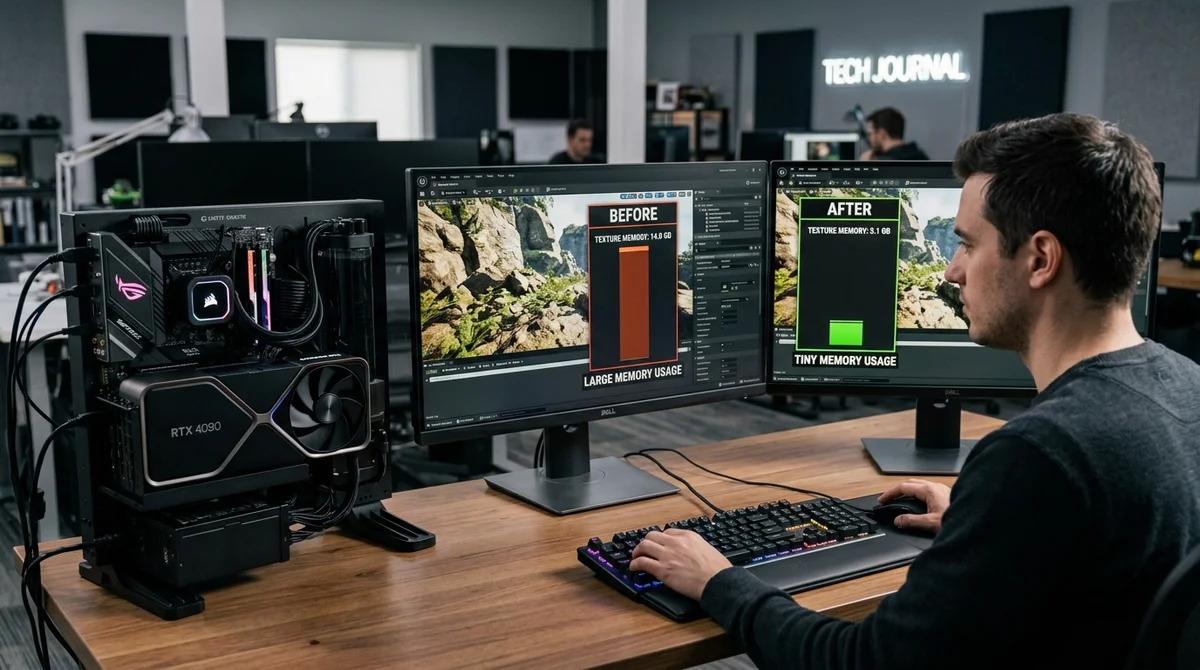
Nvidia показала нейросжатие текстур для игр: расход видеопамяти снизился почти в семь раз
На GTC 2026 Nvidia продемонстрировала Neural Texture Compression: в тестовой сцене технология сократила расход VRAM с 6,5 ГБ до 970 МБ при близком качестве картинки.
PHP и RubixML переходят от массивов к GPU: как в экосистеме меняется подход к ML
PHP-сообщество всё активнее выносит машинное обучение из массивов и циклов в нативные структуры, расширения и GPU, превращая язык из вычислителя в оркестратор…