#LLM
Подборка материалов по теме «LLM»: релизы, исследования, бенчмарки, опенсорс.

Google выпустила отдельное приложение Gemini для macOS и упростила доступ к ИИ на Mac
Google запустила отдельное приложение Gemini для macOS, чтобы владельцы компьютеров Apple могли быстрее открывать ИИ-помощника и использовать его в ежедневной…
Rufler упрощает рои в Claude Code: один конфиг вместо ручной оркестрации агентов
Open-source инструмент Rufler сводит запуск автономных агентов в Claude Code к одному конфигу, автоматически собирает роли, задачи и MCP-серверы и упрощает контроль…
Почему Infosys переучивает выпускников: индийские айтишники не готовы к эпохе ИИ
Индийские выпускники computer science все чаще приходят на работу без навыков AI-разработки, поэтому компании вроде Infosys тратят недели на их переподготовку под…
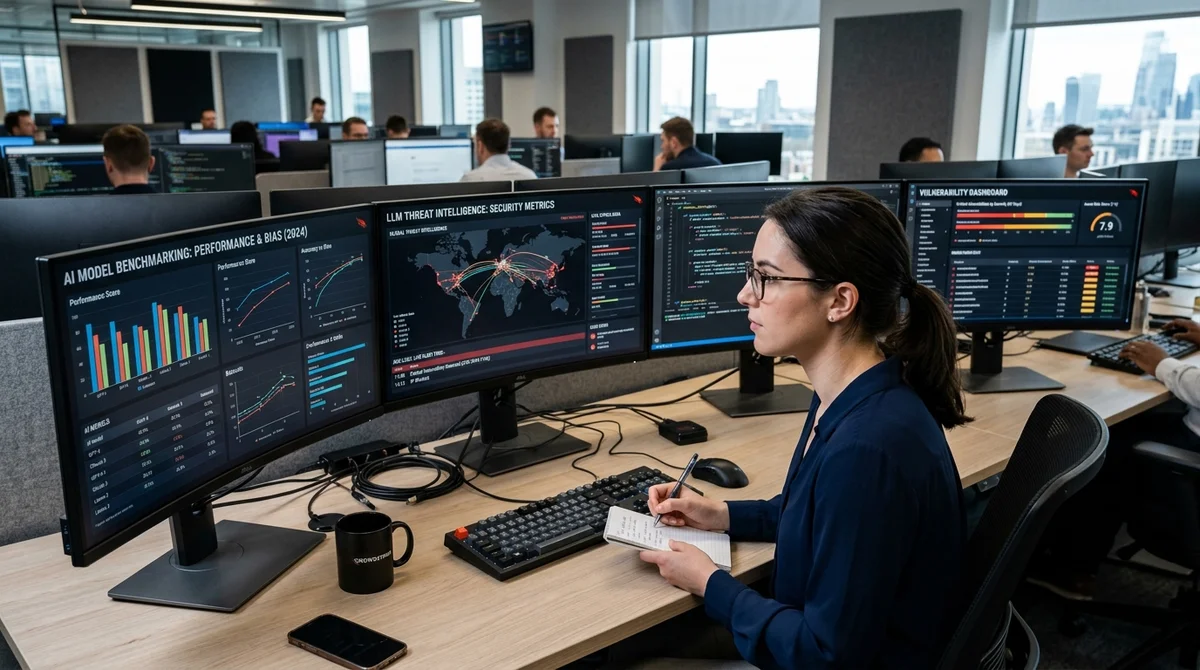
Positive Technologies перечислила лучшие бенчмарки для оценки LLM в кибербезопасности
Apple пригрозила удалить Grok из App Store после жалоб на дипфейки с обнажением
Банк Англии созывает банки Британии на брифинг из-за киберрисков модели Anthropic Mythos
Claude Sonnet помог топ-менеджерам за 8 часов собрать ИИ-директора для жёстких решений
Почему ServiceNow, Atlassian и BMC меняют рынок ITSM и спор о платформе в 2026-м
Рынок ITSM с ИИ смещается от чат-ботов к управляемой инфраструктуре, где выбор между коробкой и платформой определяют безопасность, масштаб и контроль над агентами.
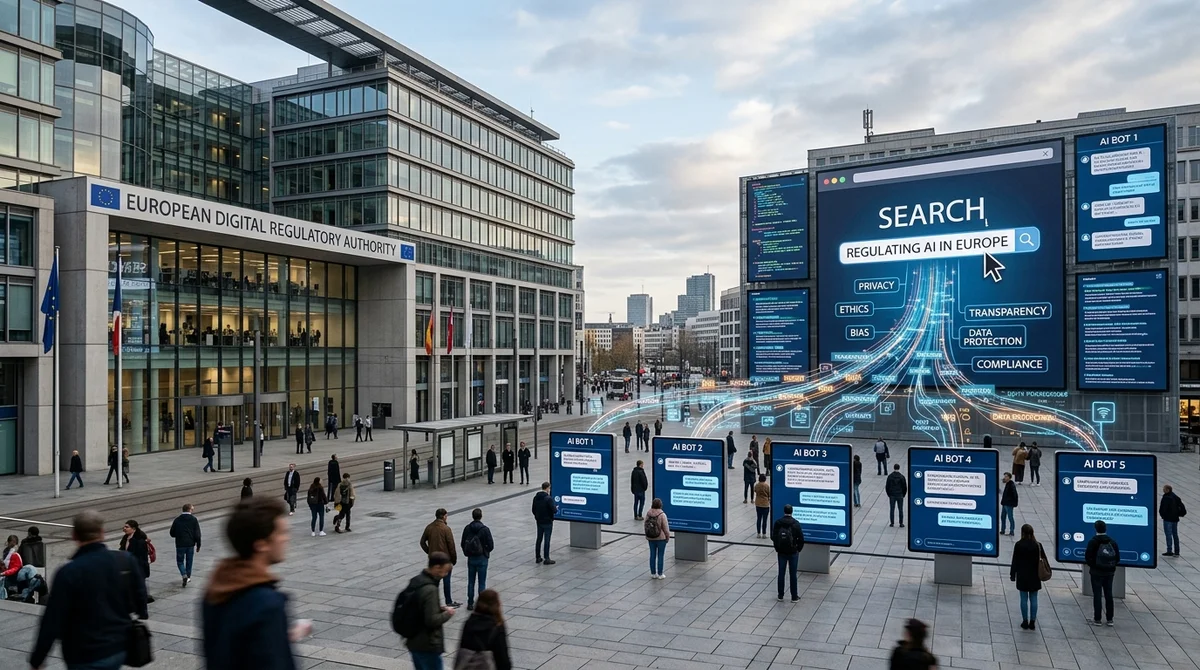
Евросоюз хочет обязать Google делиться поисковыми данными с чатботами-конкурентами
Евросоюз предложил открыть часть ключевых поисковых данных Google для конкурентов, включая ИИ-чатботы, чтобы ослабить влияние крупнейших американских техплатформ.
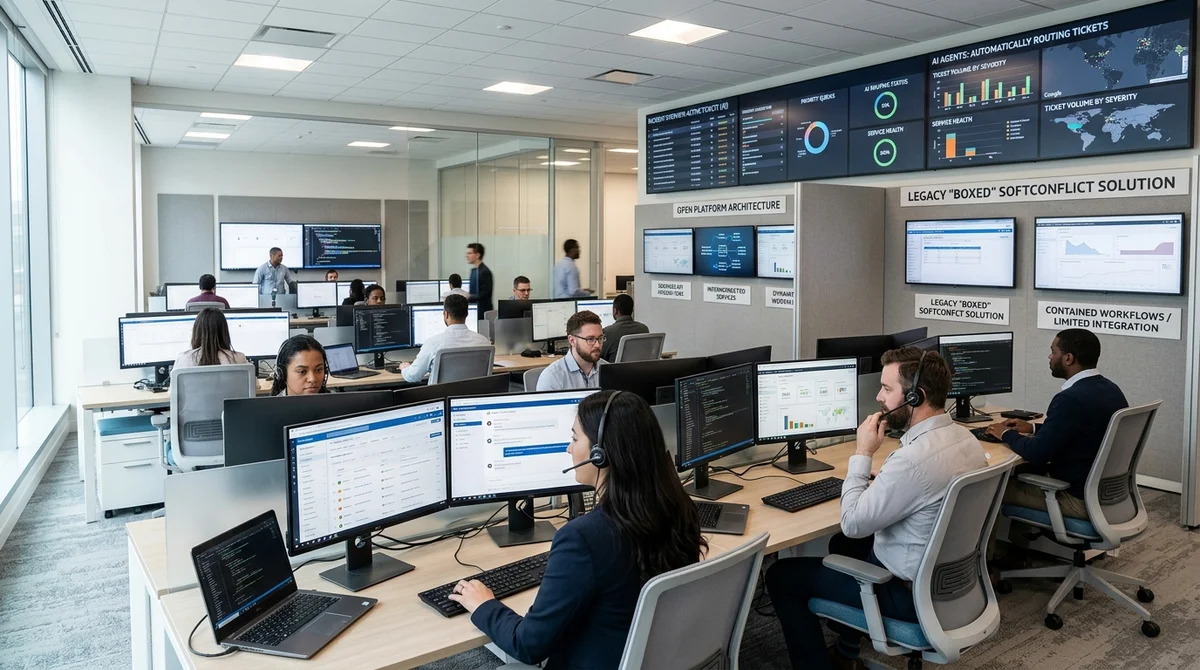
ServiceNow и Atlassian ведут рынок ITSM к AI-платформам вместо коробочных решений
Anthropic выпустила Claude Opus 4.7 — мощную кодовую модель с урезанными кибервозможностями
Wildberries & Russ описала, какой уровень зрелости данных нужен для точных ИИ-агентов
Roblox превратил встроенного ИИ-помощника в агента, который сам планирует, собирает и тестирует игры
Kodik объяснила, почему публичные бенчмарки языковых моделей вводят в заблуждение
Kodik разобрала слабые места популярных тестов для LLM и показала, почему для AI-редактора кода важнее собственный бенчмарк, а не красивые проценты в чужих таблицах.
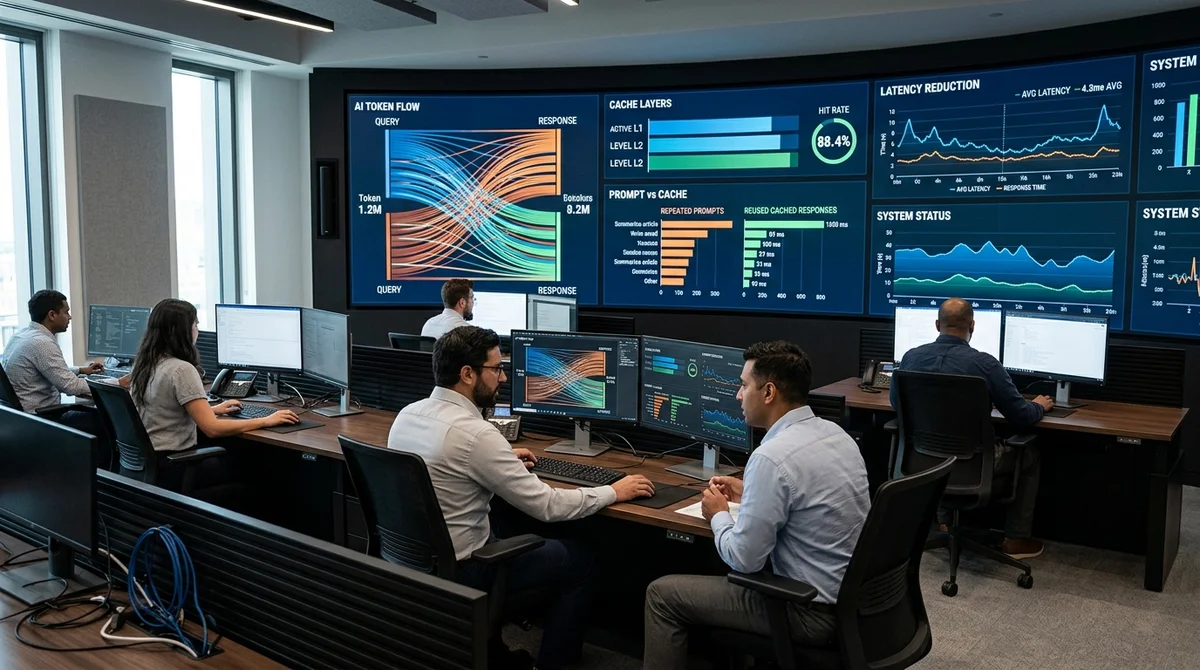
OpenAI, Anthropic и Gemini: как кэширование инференса снижает цену и задержку LLM
Кэширование инференса позволяет LLM не пересчитывать одинаковые части промпта, снижает расходы на токены и ускоряет ответы, а главным рычагом для продакшна…