Контекстное окно — не память: что должны понимать разработчики AI-агентов
Разработчики AI-агентов часто принимают большое контекстное окно за долгосрочную память — и это фундаментальная архитектурная ошибка. Контекст исчезает после каждой сессии, тогда как настоящая память требует отдельной системы: RAG, компрессии или episodic storage. Агент с окном в 2 млн токенов всё равно забудет пользователя на следующий день.
AI-обработка оригинала Machine Learning Mastery; редакция Hamidun News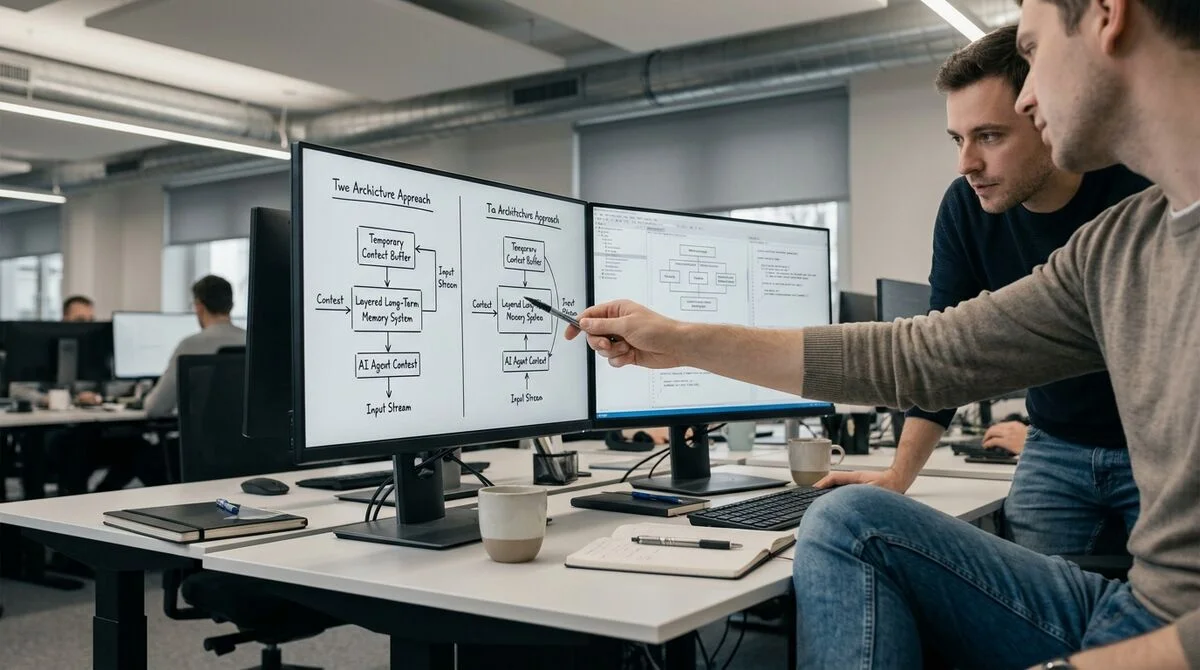
Большое контекстное окно — популярный аргумент при выборе модели для AI-агента. Но оно решает другую проблему, чем долгосрочная память. Разработчики, которые их путают, строят агентов с фундаментальным архитектурным изъяном.
Контекст — это рабочий стол, не архив
Контекстное окно работает как оперативная память компьютера: всё, что в нём есть, агент «видит» прямо сейчас и может использовать в ответе. Когда сессия заканчивается — содержимое исчезает без следа. Долгосрочная память — принципиально другое: знание сохраняется между сессиями, индексируется и вызывается по необходимости. Это отдельная система, отдельная архитектура, которая проектируется независимо от выбора модели. Агент с окном в 2 миллиона токенов по-прежнему забывает пользователя на следующий день. Увеличение размера контекста лишь откладывает столкновение с проблемой — но не устраняет её.
Пять техник настоящей памяти Разработчики AI-агентов используют несколько подходов к управлению
знаниями между сессиями: RAG (Retrieval-Augmented Generation) — агент обращается к внешней базе знаний только тогда, когда нужно, вместо того чтобы хранить всё в окне. Подходит для больших корпусов документов. Compression — длинная история разговора сжимается в краткое резюме, которое занимает в 10–20 раз меньше токенов. Episodic memory — ключевые факты о пользователе или задаче сохраняются в структурированное хранилище и загружаются в начале следующей сессии. Summarization chains — большие документы конвертируются в выжимки до того как попасть в контекст агента. * Selective storage — оркестратор решает, что важно сохранить, что сжать, что выбросить совсем. Каждый инструмент решает свою задачу. Чат-бот для поддержки нуждается в episodic memory, агент-аналитик над корпусом документов — в RAG.
Проблема заполненного контекста Есть ещё одна причина не полагаться только на большое окно:
явление «lost in the middle». Исследования показывают, что модели хуже обрабатывают информацию, которая находится в середине длинного контекста — качество ответа снижается даже при технически доступном месте. Практический вывод: даже если контекст технически вмещает 500 страниц текста, туда не стоит складывать всё подряд. Селективность и компрессия дают лучшее качество ответов, чем брутфорс-заполнение.
«Контекстное окно — это рабочий стол.
Вы не складываете на него всё, что у вас есть, — вы достаёте только то, что нужно прямо сейчас.»
Архитектура памяти для production Команды, которые строят агентов для реальных пользователей,
должны проектировать систему памяти отдельно от выбора модели. Ключевые вопросы на этапе проектирования: что нужно помнить между сессиями, каков TTL у каждого типа информации, как агент решает что сохранить, где хранить — в векторной БД, реляционной или графе знаний. Без ответов на эти вопросы агент остаётся одноразовым инструментом: пользователь вынужден объяснять контекст заново при каждом запуске. Это особенно критично в поддержке, образовании и медицине — везде, где знание о пользователе накапливается неделями.
Что это значит Выбор модели с большим контекстом — тактика.
Система памяти — это архитектура. Разработчики, которые путают одно с другим, обнаружат проблему не в прототипе, а в продукте — когда пользователи уже недовольны. Проектируйте память с первого дня.
- 12 нояб. 2026 г.Claude in Chrome требует разрешать каждый клик на сайтах с категорией 3
- 12 нояб. 2026 г.Norwest собрал рекордный фонд на $4 млрд и ставит на агентов, голос и физический ИИ
- 12 нояб. 2026 г.AWS показала, как 100% точности поиска скрывают провал ИИ-агента
- 12 нояб. 2026 г.Garage Eight убрала чужие апрувы в 69 MR внутреннего сервиса с AI-ревью
Внедряйте ИИ быстрее рынка вместе с инженерами и фаундерами
Внутри Vibe Club (hamidun.com/club): еженедельные живые мастермайнды и разборы архитектуры с Жемалом Хамидуном, закрытый Tech Radar, LMS и обновляемая база из 370+ боевых скиллов.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.