Machine Learning Mastery
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации

Схема пройдена, а сумма в счёте занижена в 10 раз: как проверять structured output LLM
Pydantic принял ответ модели, схема сошлась, а в счёте 1 250 евро превратились в 125. Разбираем, как ловить такие ошибки: валидация по источнику, ограниченные ретраи и constrained decoding.

Как запереть код ИИ-агента: subprocess, Docker и microVM — три уровня защиты
Агент, который пишет и запускает код, безопасен ровно настолько, насколько безопасно место запуска. Разбираем три уровня изоляции — от subprocess до Firecracker — и цену каждого.

Сколько памяти съест модель: как GQA, окна и MLA меняют KV-кэш
Две модели с одинаковым числом параметров могут требовать разной памяти на инференсе. Разбираем, как устроен KV-кэш и как прикинуть, сколько запросов потянет ваша GPU.

Groq обработал пять отзывов за 2 секунды, Ollama — за 81: что скрывает тест
Где классифицировать отзывы: на своём компьютере или через API? Учебный тест показал разницу почти в 40 раз, но сравнивал разные модели. Разбираем, что полезно проверить на своих данных.

Unsloth превращает Qwen3.5-4B в классификатор 10 намерений на одной T4
Когда от модели нужен не красивый ответ, а выбор следующего действия, генерация становится лишней. Unsloth предлагает обучить Qwen3.5-4B выбирать намерение пользователя и возвращать уверенность.

16-битные форматы сокращают память весов модели вдвое без смены архитектуры
Один и тот же ИИ может занимать 28 или 14 ГБ — всё решает формат чисел. Но слепой переход на меньшее число битов способен замедлить модель и испортить ответы.

DiffusionGemma от Google пишет текст блоками по 256 токенов сразу, а не по одному
Google выпустила экспериментальную open-модель, которая не печатает слово за словом, а «проявляет» целый абзац из шума. Разбираем, как её запустить и чем она отличается от обычных LLM.

pgvector против Qdrant: бенчмарк на 100 000 векторов размерности 1536
Machine Learning Mastery предлагает воспроизводимый замер pgvector и Qdrant: одинаковый HNSW, 1536 измерений, 100 тысяч векторов, p50/p95/p99 и QPS на обычном ноутбуке.

Machine Learning Mastery показал, как собрать RAG на scikit-learn без векторной базы
Machine Learning Mastery разобрал лёгкий сквозной RAG: эмбеддинги от открытых моделей, поиск по векторам на scikit-learn и сборка ответа с найденным контекстом.

Unsloth и Llama 3: как научить модель стабильно вызывать API через JSON
Machine Learning Mastery разбирает дообучение Llama 3 под строгий JSON для tool calling через Unsloth: универсальная модель ломает схему API, а LoRA помогает это исправить.

Как создать браузерного AI-агента на Python — пошаговый гайд Machine Learning Mastery
Machine Learning Mastery опубликовал гайд по созданию Python-агентов, которые управляют браузером — открывают сайты, кликают и заполняют формы без официального API.

Transformers.js и эмбеддинги: семантический поиск без серверной инфраструктуры
Machine Learning Mastery разбирает, как заменить keyword-поиск семантическим с помощью Transformers.js — браузерная библиотека строит векторные эмбеддинги прямо на клиенте без серверного API.

Агентный AI-пайплайн: 7 компонентов, которые отличают продакшн от демо
Machine Learning Mastery опубликовал руководство с семью архитектурными компонентами, которые отличают продакшн-систему агентного AI от обычного демо-скрипта.

Как ИИ-агенты управляют контекстным окном в долгих задачах: пять стратегий
Machine Learning Mastery разобрал пять практических стратегий управления контекстным окном для ИИ-агентов, которые работают часами и упираются в лимит токенов модели.

LangChain vs LlamaIndex: как разработчики выбирают фреймворк для LLM-приложений
Разработчики LLM-приложений обычно начинают с прямых запросов к API, но по мере усложнения кода переходят на специализированные фреймворки вроде LangChain или LlamaIndex.
ИИ-агенты для бизнеса: выбор инструментов пошагово
Machine Learning Mastery опубликовал гайд по выбору инструментов для AI-агентов: почему меньше часто лучше и как качество описаний влияет на надёжность агента.
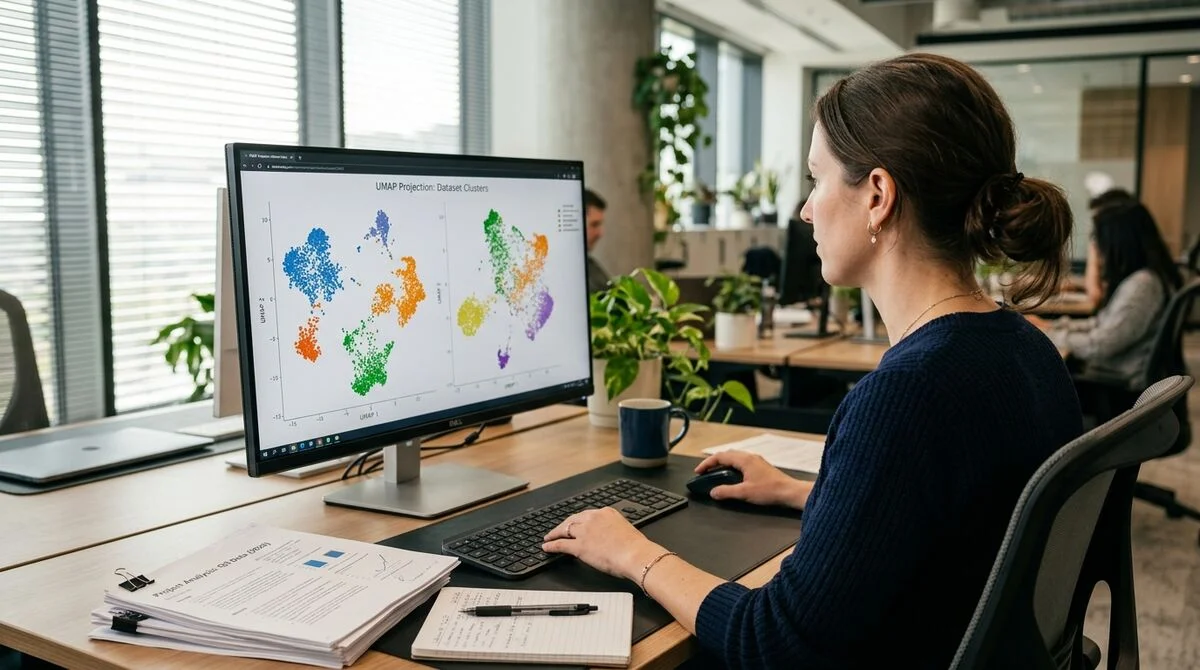
Кластеризация текстов без разметки: LLM-эмбеддинги и HDBSCAN от Machine Learning Mastery
Machine Learning Mastery показывает, как группировать неструктурированный текст по темам с LLM-эмбеддингами и HDBSCAN — без ручной разметки и заранее известного числа категорий.
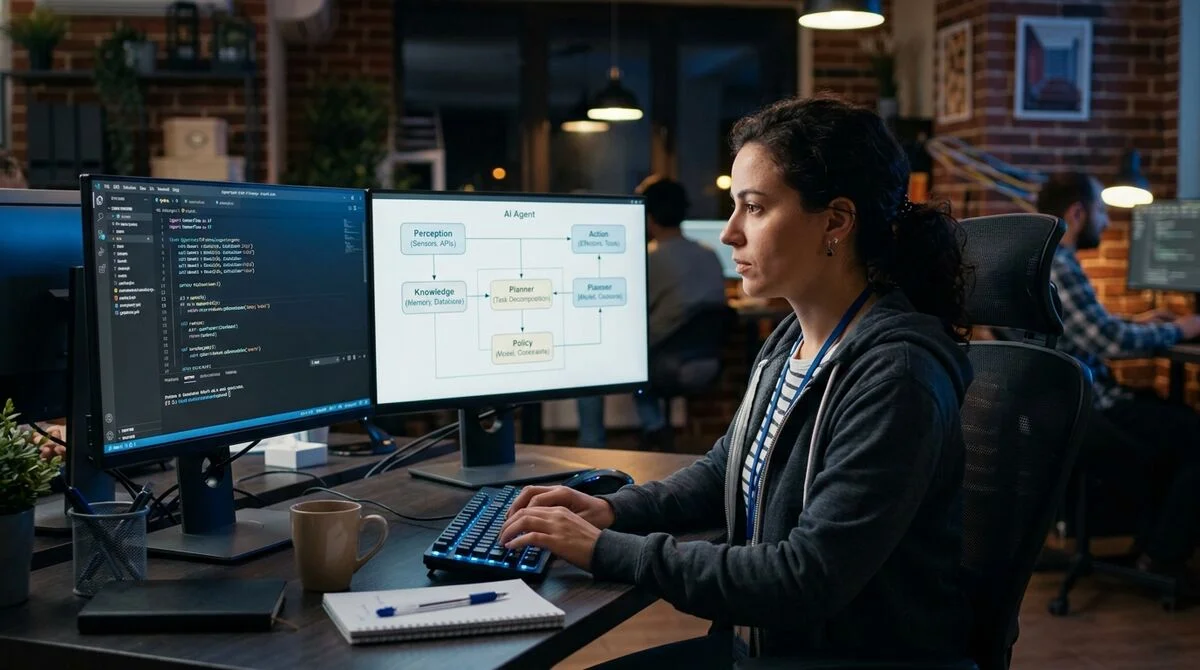
Как устроены AI-агенты: LLM, Claude и ChatGPT на практике
Machine Learning Mastery разбирает, из каких компонентов строится современный AI-агент: фреймворк оркестрации, слои памяти, инструменты для действий и мониторинг.
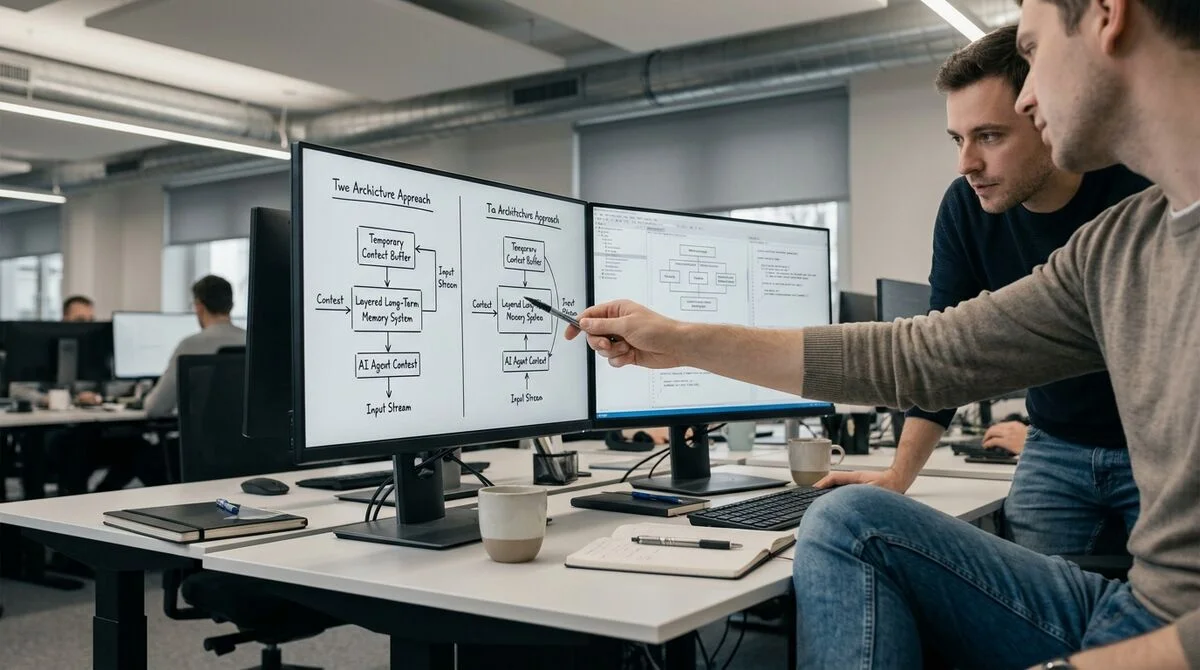
Контекстное окно — не память: что должны понимать разработчики AI-агентов
Разработчики AI-агентов часто путают большое контекстное окно с долгосрочной памятью — это архитектурная ошибка, которая проявляется в production при работе с повторными пользователями.
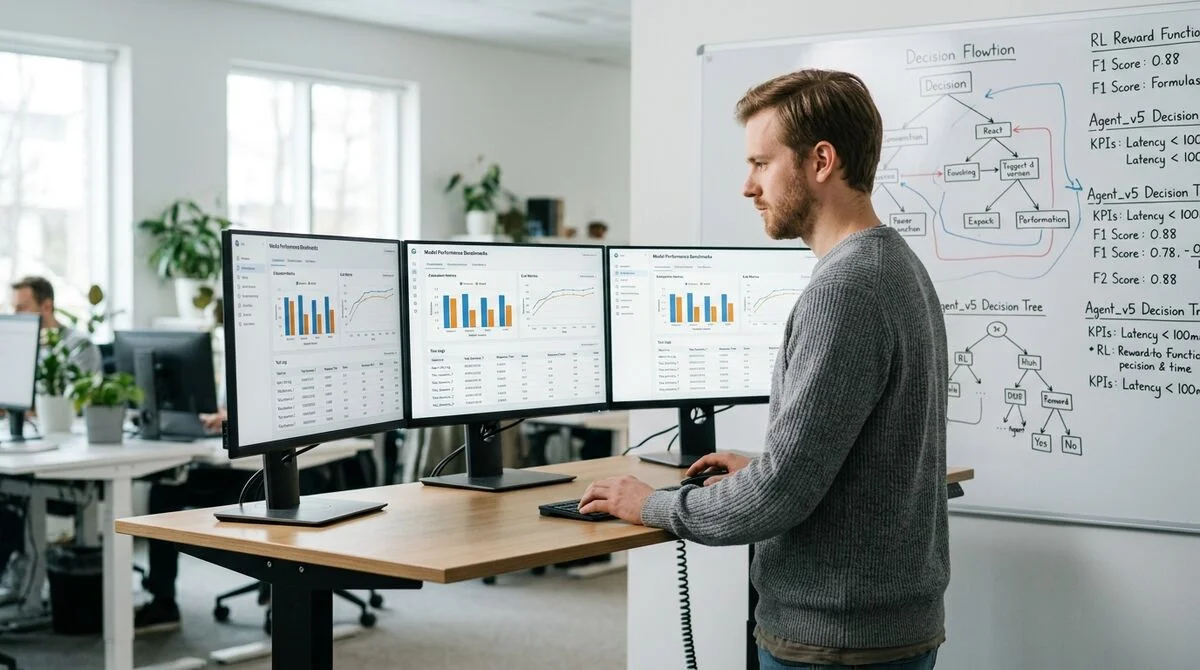
Дорожная карта оценки AI-агентов: метрики, бенчмарки и практические методы
Оценивать AI-агентов сложнее, чем языковые модели: нужны отдельные метрики для многошаговых задач, использования инструментов и восстановления после ошибок.
Scikit-LLM: сквозной пайплайн анализа тональности текста с языковыми моделями
Scikit-LLM встраивает GPT и другие LLM в sklearn-пайплайны — анализ тональности без разметки данных и дообучения, в привычном sklearn-интерфейсе.
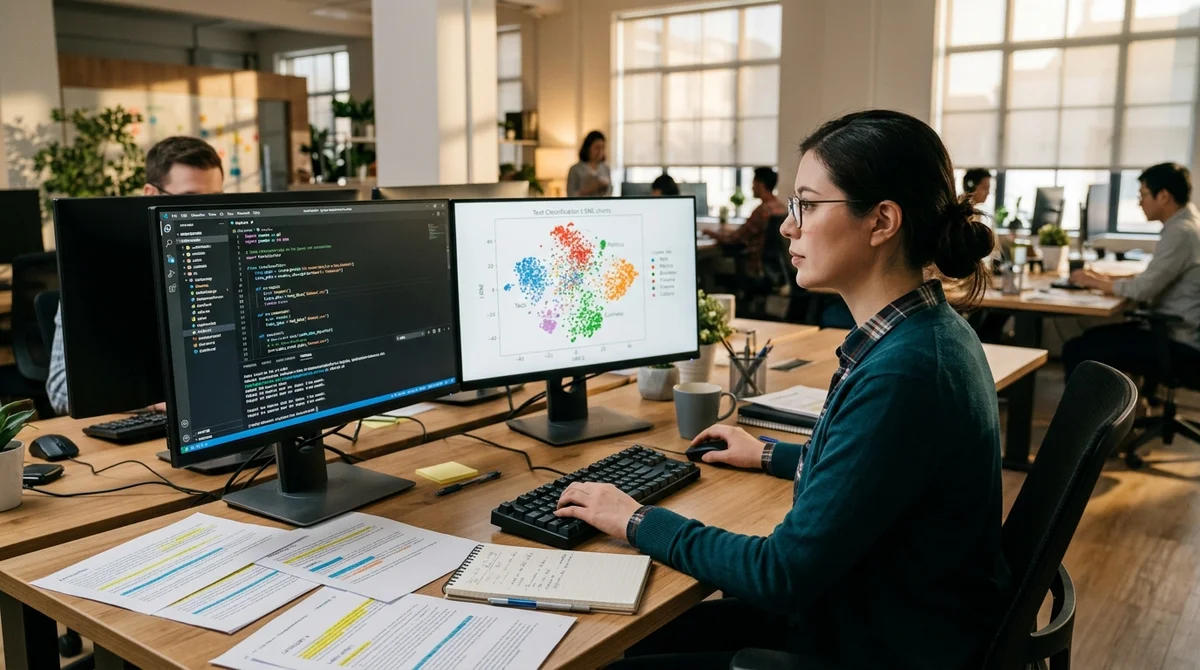
Scikit-LLM: мультиметочная классификация текста без обучающей выборки через LLM
Библиотека Scikit-LLM позволяет присваивать каждому тексту сразу несколько тегов без обучающей выборки — используя GPT-4 и совместимые модели через привычный scikit-learn-интерфейс.
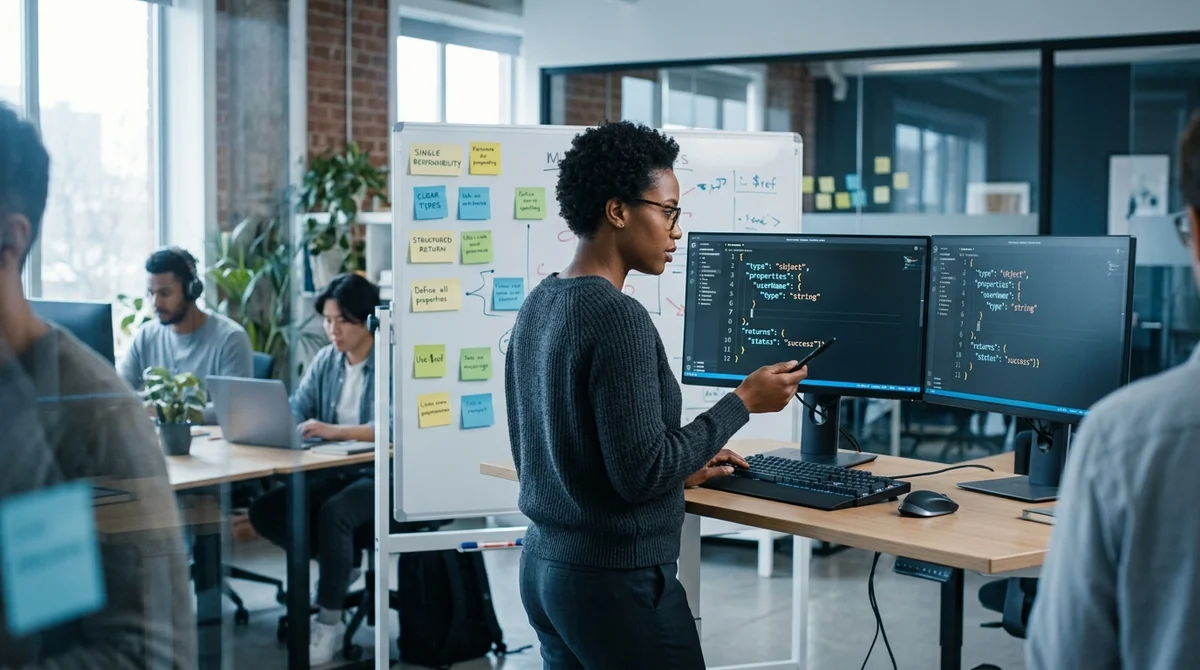
Как проектировать инструменты для AI-агентов: рабочие практики и типичные ошибки
Machine Learning Mastery разобрал, почему AI-агент работает ровно настолько хорошо, насколько грамотно спроектированы его инструменты — и какие ошибки делают их бесполезными.
Machine Learning Mastery: Python-концепции, которые AI-инженер обязан освоить для продакшна
Machine Learning Mastery объяснил, какие Python-паттерны отделяют экспериментальные скрипты от масштабируемых AI-систем, выдерживающих реальную нагрузку.
Как работает выбор токенов в нейросетях: logits, температура и top-p
Разбираемся в математике генерации текста LLM: как logits, температура и top-p влияют на баланс между точностью и творческостью ответов.
Context pruning ИИ-агентов: долгие сессии без переполнения
Агенты на базе больших языковых моделей требуют нового подхода к управлению памятью при долгих сессиях. Контекст-pruning позволяет удалять ненужную информацию и экономить токены.
Гибридный поиск в RAG: когда семантика встречает ключевые слова
Гибридный поиск комбинирует семантический и лексический алгоритмы — это критично для RAG систем, готовых к production.
ChatGPT для анализа текста: мультиагентный ассистент
OpenAI представила Agents SDK — фреймворк для создания систем из нескольких агентов, которые работают вместе для поиска и анализа информации. Это открывает новые возможности для автоматизации исследований.
Семантический поиск: как нейросеть ищет без ключевых слов
Обычный поиск по ключевым словам ломается, когда документ не содержит буквально то слово, которое ищет пользователь. Machine Learning Mastery показывает, как это решить LLM embeddings и метаданными.
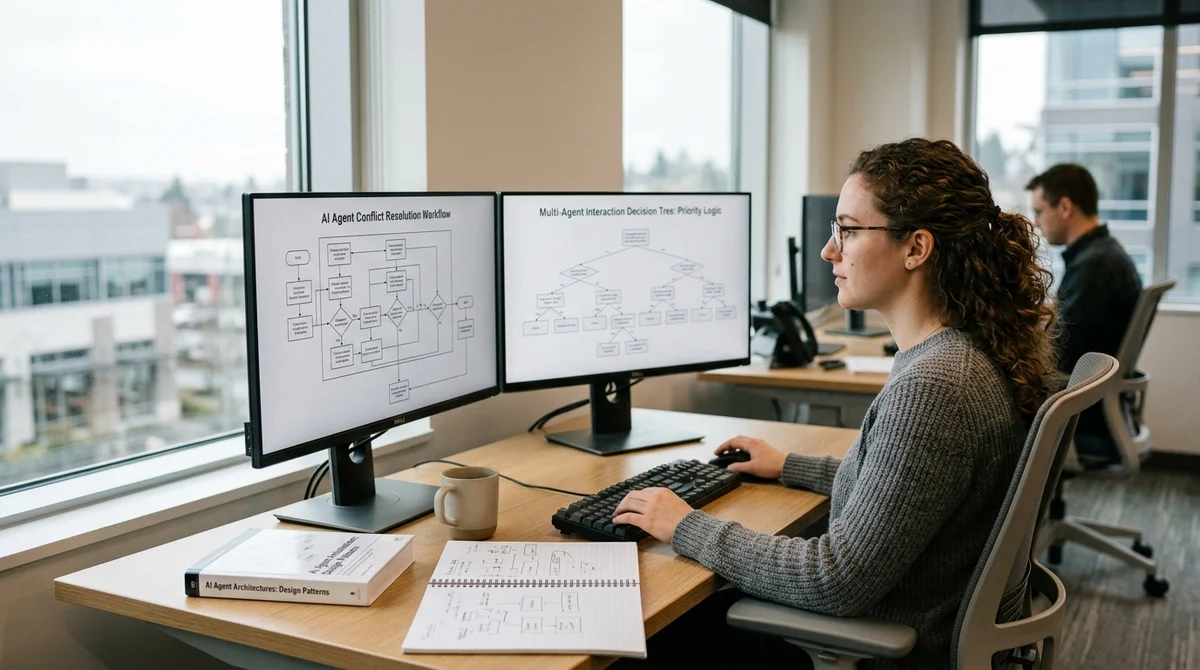
Как выбрать архитектуру AI-агента: дерево решений от Machine Learning Mastery
Machine Learning Mastery опубликовала гайд с деревом решений для выбора оптимального паттерна проектирования AI-агента. Выбор зависит от типа задачи, требований к масштабируемости и характера взаимодействия с внешними си