KDnuggets опубликовал гайд по локальному анализу звонков с Whisper, BERTopic и Streamlit
KDnuggets показал, как собрать локальный анализатор клиентских звонков без облачных API. В связке используются Whisper для расшифровки аудио, RoBERTa из Hugging Face для тональности и эмоций, BERTopic для тем и Streamlit для дашборда. Проект запускается на своей машине, требует Python 3.9+, FFmpeg и около 1,5–2 ГБ под модели.
AI-обработка оригинала KDnuggets; редакция Hamidun News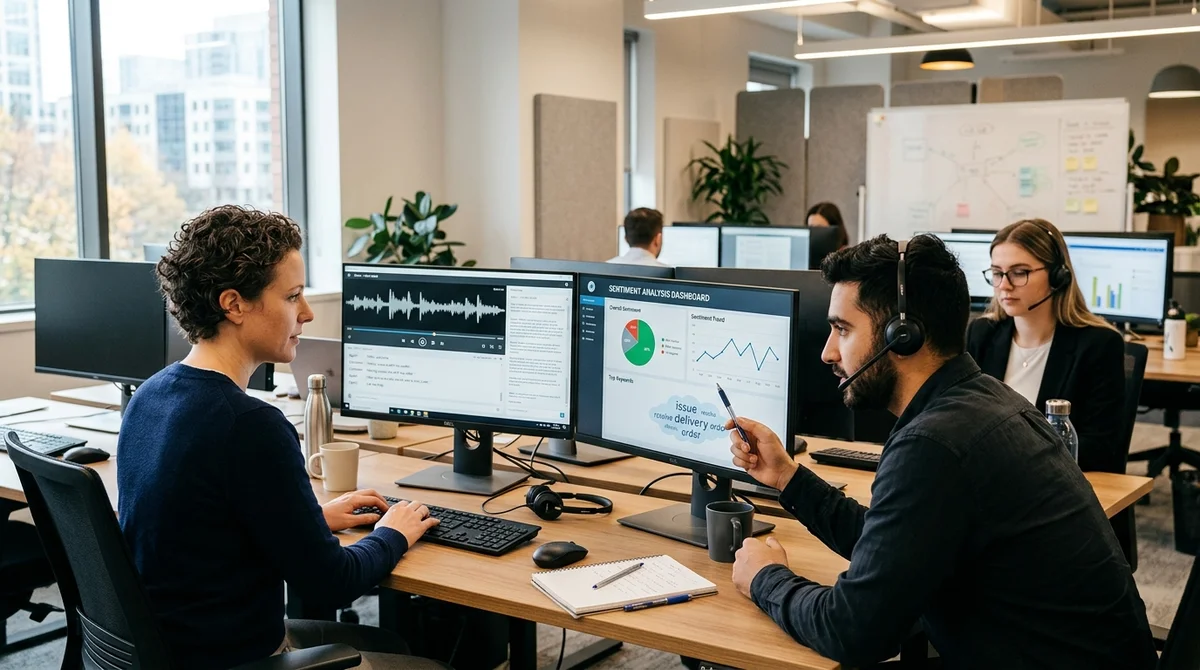
17 апреля 2026 года KDnuggets опубликовал пошаговый разбор open-source инструмента для анализа клиентских звонков. Проект собирает локальный пайплайн: Whisper расшифровывает аудио, модели из Transformers определяют тональность и эмоции, а BERTopic находит повторяющиеся темы без отправки записей во внешние API.
Как работает стек Материал построен вокруг простой модульной схемы, которую можно повторить на обычной машине.
Сначала Whisper превращает запись звонка в текст и нарезает её на сегменты с таймкодами. Автор использует базовую или small-версию модели как компромисс между скоростью и качеством. Дальше транскрипт уходит в модель cardiffnlp/twitter-roberta-base-sentiment-latest, которая считает вероятности для positive, neutral и negative, а затем выводит итоговую метку и compound-оценку от минус одного до плюс одного.
После этого BERTopic группирует разговоры по смыслу и вытаскивает ключевые темы вроде проблем с биллингом, доставкой или техподдержкой. Отдельно автор объясняет, почему тема и тональность решают разные задачи. Тональность отвечает на вопрос, хороший был опыт или плохой, а эмоции показывают, что именно чувствует клиент: раздражение, срочность, удовлетворение.
Для тем используется связка sentence-transformers, UMAP, HDBSCAN и c-TF-IDF. Важная практическая деталь: извлечение тем начинает нормально работать не на одном звонке, а хотя бы на наборе из пяти-десяти транскриптов, где уже видны повторяющиеся паттерны.
Почему локальный запуск Главная идея статьи — не просто сделать ещё один NLP-демо-проект, а
показать полезный корпоративный сценарий без зависимости от облачных API. Для колл-центров это упирается в приватность, стоимость и требования к хранению данных. После первой загрузки моделей, которая занимает примерно 1,5 ГБ, система может работать офлайн. Для старта нужны Python 3.9+, FFmpeg для обработки аудио и около 2 ГБ места на диске, то есть порог входа довольно низкий даже для небольшой команды.
«Главный плюс — всё работает локально, а чувствительные данные клиентов не покидают твою машину».
В статье это подано как аргумент не только про безопасность, но и про предсказуемость затрат. Нет платы за каждый вызов API, нет лимитов провайдера и нет риска, что очередную клиентскую запись придётся отдавать во внешнюю инфраструктуру. Автор также сравнивает трансформеры с более старыми словарными методами вроде VADER: простые модели могут ошибаться на фразах с отрицанием, а трансформер лучше понимает контекст разговорной речи, что особенно важно для реальных жалоб и неоднозначных формулировок.
Что показывает дашборд Финальный слой проекта — интерфейс на Streamlit с графиками
Plotly, ориентированный уже не на ML-инженера, а на менеджера или аналитика. Через него можно загрузить несколько mp3 или wav-файлов, дождаться обработки и сразу посмотреть сводку по звонкам. Для ускорения используется кеширование ресурсов, чтобы тяжёлые модели не перезагружались при каждом действии в интерфейсе. Запуск предусмотрен в нескольких режимах: демо без аудио, анализ одного файла, пакетная обработка каталога и полный дашборд в браузере.
- Загрузка аудиофайлов и пакетная обработка Транскрипт с подсветкой тональности Таймлайн эмоций для длинных разговоров Визуализация тем и распределения звонков по кластерам Переход к конкретному разговору По сути, это готовый каркас для внутренних сервисов поддержки, продуктовой аналитики и контроля качества операторов. Команда может взять репозиторий, поменять входные данные, дообучить или заменить модели и быстро получить прикладной инструмент вместо абстрактного ноутбука. Именно этим статья и ценна: она не спорит о будущем агентных систем, а показывает конкретный, воспроизводимый сценарий, где open-source стек уже решает бизнес-задачу.
Что это значит Такие публикации показывают, как быстро AI-инструменты переходят из разряда
экспериментов в практику операционных команд. Если раньше анализ звонков часто требовал SaaS-сервиса и внешней обработки данных, то теперь базовую систему можно собрать локально, прозрачно и без больших бюджетов на API.
- 12 нояб. 2026 г.n8n выпустила Nod — open-source агента, который работает на вашем компьютере
- 12 нояб. 2026 г.Claude Code и Codex режут реверс-инжиниринг: OpenAI банила аккаунты по ошибке
- 12 нояб. 2026 г.QA-инженеры SpaceWeb поручили ИИ писать автотесты: рабочий скрипт за 50 минут
- 12 нояб. 2026 г.MiniMax открыла веса H3-Image: 4K-картинки за 10–16 секунд и 16 референсов
Внедряйте ИИ быстрее рынка вместе с инженерами и фаундерами
Внутри Vibe Club (hamidun.com/club): еженедельные живые мастермайнды и разборы архитектуры с Жемалом Хамидуном, закрытый Tech Radar, LMS и обновляемая база из 370+ боевых скиллов.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.