FlashAttention-4: как Together AI ускорила внимание на GPU Blackwell
FlashAttention-4 переделала ядро внимания специально под Blackwell. Ускорение дают новая tensor memory (TMEM) и режим 2-CTA MMA, которые решают узкое место — не в скорости матричных операций, а в SFU для софтмакса и в памяти. Результат: 1605 TFLOPs/s (71% утилизации), 1.3× vs cuDNN и 2.7× vs Triton.
AI-обработка оригинала Together AI Blog; редакция Hamidun News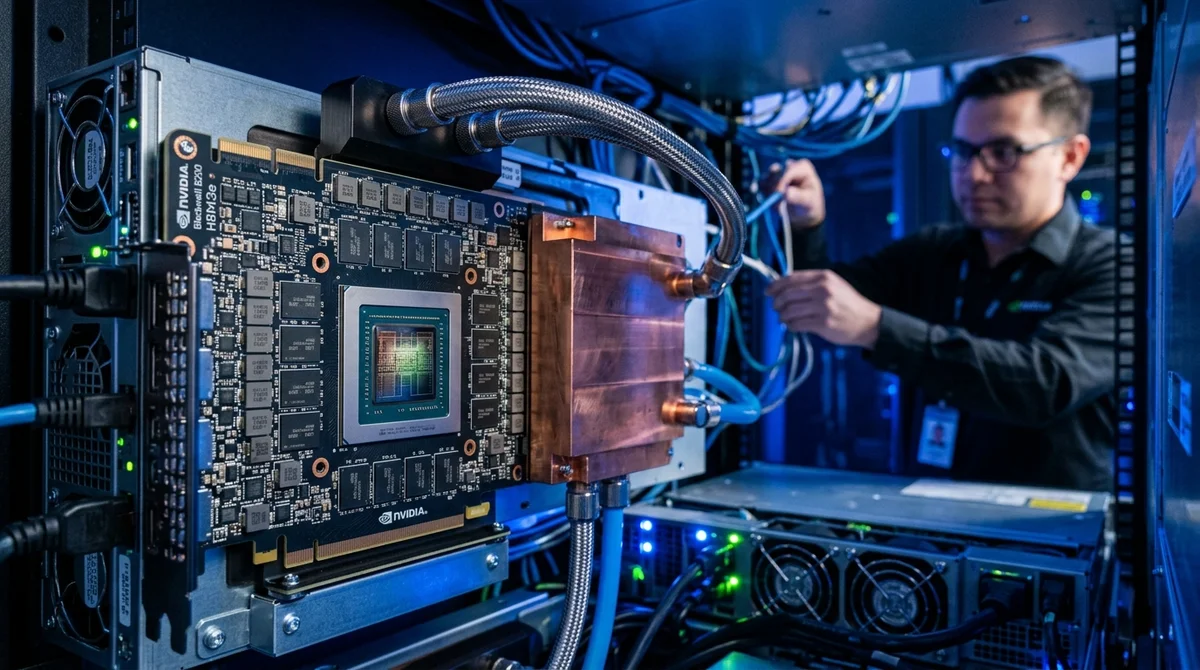
FlashAttention-4 — это переделка алгоритма внимания специально для современных GPU, где тензорные ядра растут в производительности значительно быстрее, чем память и другие ресурсы.
Почему стандартный подход больше не работает
На первый взгляд, производительность внимания (attention) контролируется скоростью двух матричных умножений: S = Q × K^T и O = P × V. Но анализ Blackwell B200 показывает неожиданное: узкое место находится не в тензорных ядрах, а в специальных функциональных блоках (SFU) для вычисления экспоненты в софтмаксе (forward pass) и в трафике shared memory (backward pass). От Hopper (H100) к Blackwell (B200) производительность BF16 тензорных ядер выросла с 1 до 2.25 петафлопс, а количество SFU и пропускная способность shared memory остались прежними. Эта асимметрия ломает стандартную оптимизацию — нельзя просто предположить, что ядра полностью определяют производительность. В действительности они мешают друг другу.
Как Together AI решила проблему Исследовательская группа вместе с инженерами NVIDIA,
Meta и Princeton предложила три ключевые идеи: Новое пайплайнирование — софтовые конвейеры, которые максимально перекрывают работу тензорных ядер, SFU и памяти без простоев. Имитация экспоненты через полиномы — вместо медленного SFU блока forward pass считает экспоненту на быстрых FMA единицах (fused multiply-add). * TMEM и 2-CTA MMA — использование новой tensor memory (256 KB per SM) плюс режим, где две thread-блокировки работают над одной матричной операцией, снижая трафик shared memory.
Возможности Blackwell, которые это сделали
Blackwell специально добавила несколько фич для таких оптимизаций: Tensor memory (TMEM) — быстрое на-чипсе хранилище (256 KB на каждый SM), проводное прямо в тензорные ядра. Промежуточные результаты могут оставаться в TMEM без похода в более медленную shared memory, что кардинально снижает задержку доступа. Асинхронные тензорные ядра 5-го поколения — каждое ядро запускается одним потоком и накапливает результаты в TMEM. Максимальный тайл для BF16 — 128×256×16 (примерно в 2 раза больше, чем у Hopper), что позволяет глубже пайплайнировать без переполнения регистров. 2-CTA MMA — новый режим, где две thread-блокировки одновременно работают над одной матричной операцией. Это сокращает нагрузку на shared memory вполовину и уменьшает количество atomic операций.
Цифры и результаты FlashAttention-4 на Blackwell B200 с BF16 достигает 1605 TFLOPs/s (71% утилизации).
Это на 1.3× быстрее, чем cuDNN 9.13, и на 2.7× быстрее, чем Triton. Для контекста: 1605 петафлопс — это почти половина от пиковой производительности Blackwell, но выжимается именно из сложного ядра внимания.
Что это значит FlashAttention-4 показывает, как нужно работать в эпоху асимметричного
масштабирования GPU — не вертеть гайки в старых алгоритмах, а переделывать их совместно с новыми возможностями железа. Результат выглядит как достижение, но это просто начало подгонки под новую реальность аппаратуры. *Meta признана экстремистской организацией и запрещена в РФ.
- 12 нояб. 2026 г.Meta* включила ИИ-проверку возраста в Instagram* по всему миру: детей до 13 лет удалят
- 12 нояб. 2026 г.Meta вывела Muse на часы Apple и Android с тремя способами общения
- 12 нояб. 2026 г.Anthropic запустила Claude Meetings: ИИ садится в Google Meet и сразу ведёт задачи
- 12 нояб. 2026 г.SEO-текст стал вектором атаки: агент-ресерчер выполнил чужую инструкцию с сайта
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.