Нейросети работают в 2 раза быстрее: FlashAttention-3 от NVIDIA
Together AI представила FlashAttention-3 — новый алгоритм для ускорения трансформеров в больших языковых моделях. Работает вдвое быстрее, чем FlashAttention-2. GPU H100 загружается теперь на 75% вместо прежних 35%. Алгоритм поддерживает низкую точность вычислений FP8, при этом сохраняя точность результатов. Это позволяет LLM эффективнее обрабатывать длинные текстовые последовательности без замедления вычислений и снижает затраты.
AI-обработка оригинала Together AI Blog; редакция Hamidun News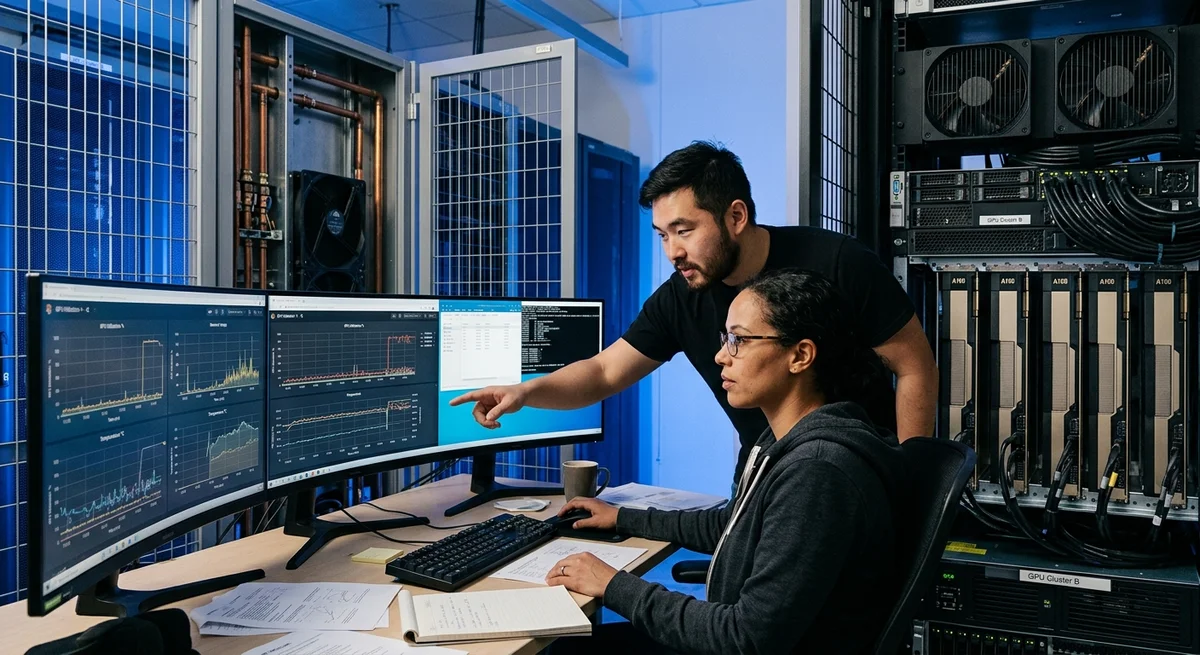
Нейросети теперь работают в 1.5–2 раза быстрее: Together AI, NVIDIA и Meta выпустили FlashAttention-3 — алгоритм для ускорения внимания в трансформерах, который использует 75% мощности GPU вместо прежних 35%.
Почему ускорение нейросетей экономит деньги?
Облачные вычисления дорожают, а LLM требуют всё больше ресурсов. Каждый процент эффективности теперь считается в деньгах.
- 12 нояб. 2026 г.Meta* включила ИИ-проверку возраста в Instagram* по всему миру: детей до 13 лет удалят
- 12 нояб. 2026 г.Meta вывела Muse на часы Apple и Android с тремя способами общения
- 12 нояб. 2026 г.Anthropic запустила Claude Meetings: ИИ садится в Google Meet и сразу ведёт задачи
- 12 нояб. 2026 г.SEO-текст стал вектором атаки: агент-ресерчер выполнил чужую инструкцию с сайта
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.