Habr AI
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации
Как Just AI помогла банку пробить потолок автоматизации с помощью LLM-агентов
Сотни веток NLU-сценария — и процент автоматизации всё равно стоит. Just AI перевела поддержку банка на LLM-агентов и добавила агента-судью против галлюцинаций.
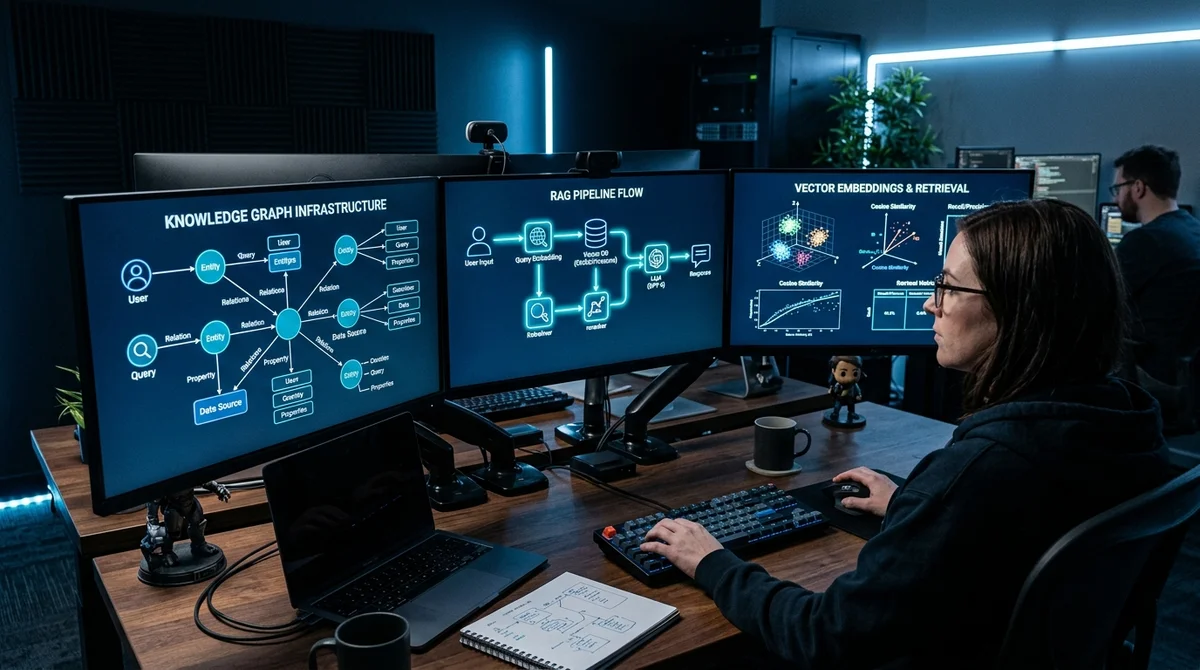
10 RAG-подходов, которые реально работают в продакшене: от базового к GraphRAG
Практический разбор 10 RAG-техник — от naive RAG и гибридного поиска до GraphRAG и Self-RAG — с указанием, когда каждую применять в реальных проектах.
SENSE: почему рынок LLM превращает модели из сервиса в платный доступ к мышлению
Автор SENSE предлагает смотреть на LLM не как на очередной SaaS, а как на инфраструктуру: токены становятся единицей доступа к мышлению, а цена и безопасность — главным полем конкуренции.
Сбер: граф знаний Yago почти не помог поиску, а LightRAG добавил 12 п.п. точности
Команда Сбера сравнила два подхода к улучшению поиска: готовый граф Yago почти не изменил качество, а LightRAG на собственных документах дал прирост точности на 12 п.п.
Hugging Face и ModelAudit: исследование показало пределы встроенной защиты ML-моделей
Эксперимент на моделях Hugging Face показал, что ModelAudit находит дополнительные опасные сигналы, но часто шумит, а точность выводов сильно зависит от версий правил и ручного триажа.
Для z.ai GLM-5.1 собрали локальное зрение: 8B-модель закрыла 70% разрыва до фронтира
Автор показал, как добавить дешёвому кодинг-агенту на базе z.ai GLM-5.1 локальное «зрение» через MCP-сервер и qwen3-vl:8b, чтобы он сам проверял интерфейс по скриншотам.
Федеральное казначейство запустило ИИ-мониторинг строек нацпроектов на базе QMonitoring
Федеральное казначейство подключило QMonitoring для круглосуточного контроля строек нацпроектов: ИИ по видео выявляет риски, сбои и отставания по срокам.
Aurora предлагает манифест устойчивого ИИ — с памятью, идентичностью и развитием
На Habr AI вышел манифест о «устойчивом ИИ»: автор предлагает оценивать системы не по бенчмаркам, а по способности сохранять идентичность, меняться и воспроизводиться во времени.
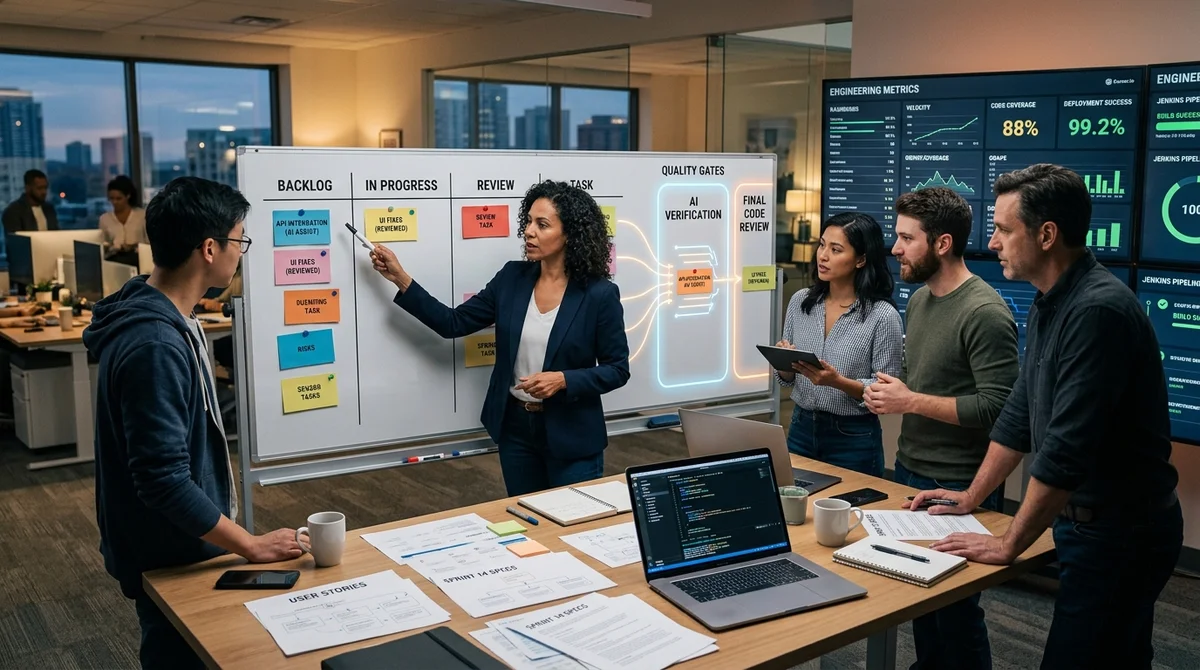
SENAR вводит ворота качества для ИИ-разработки: как спецификации и метрики снижают ошибки
На Habr вышла новая часть серии о SENAR: автор показывает, как обязательные спецификации, входные и выходные шлюзы и метрики вроде FPSR и MIR снижают число багов и ручных правок.
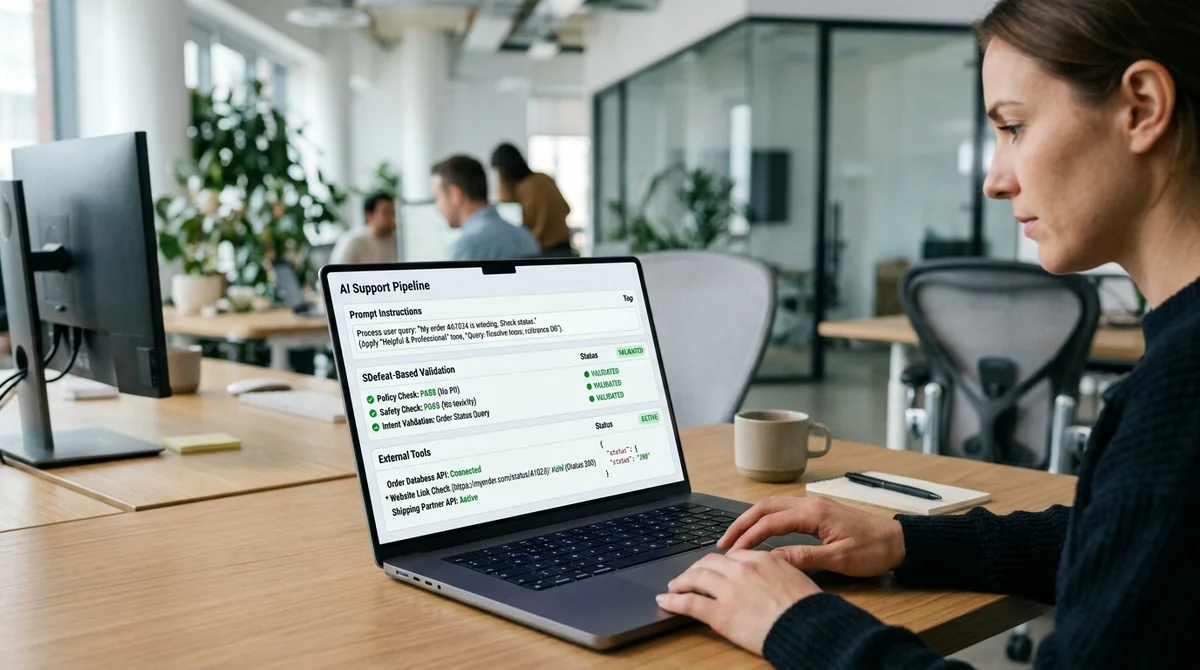
В OpenWebUI разобрали, как связать System Prompt, Skills и MCP Tools для проверки ссылок
На примере бота техподдержки в OpenWebUI показали, зачем разделять системный промпт, Skills и MCP Tools, если нужно не только сгенерировать ссылку, но и проверить, что она реально открывается.
Anthropic изменила характер Claude Opus 4.7 — и часть разработчиков увидела регресс
После релиза Claude Opus 4.7 Anthropic пообещала более прямую и точную модель, но часть разработчиков столкнулась с лишними спорами, ростом расхода токенов и поломкой старых промптов.
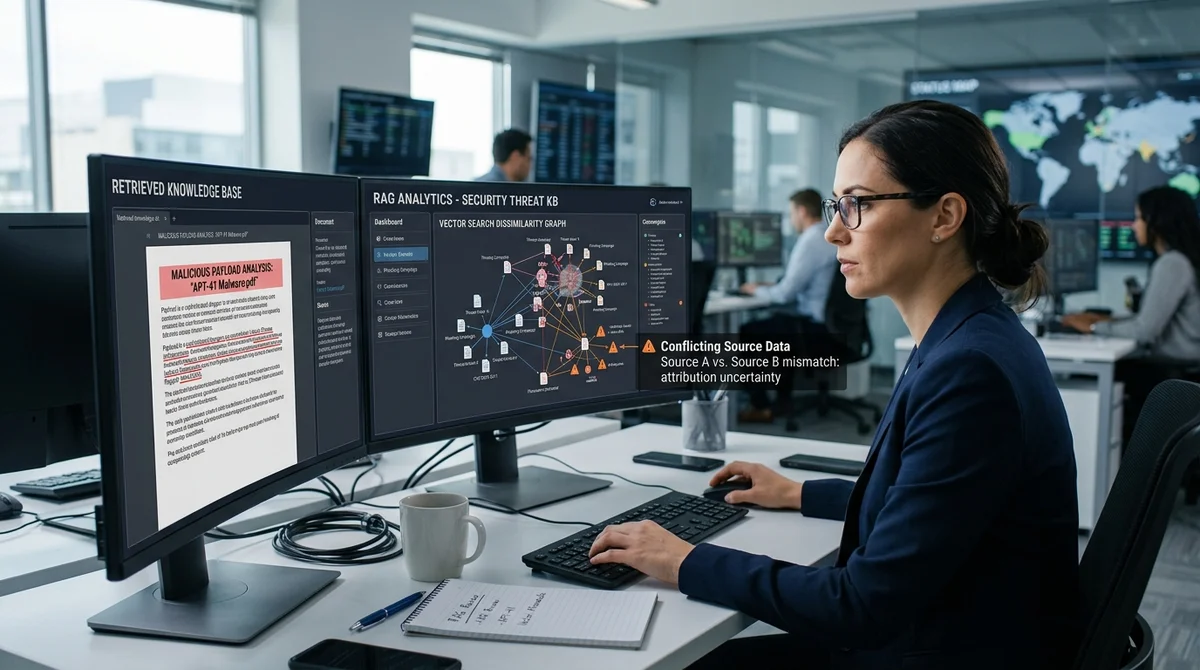
Как пять документов могут сломать RAG-систему и превратить базу знаний в канал атаки
RAG снижает галлюцинации, но доверенный контекст из базы знаний сам становится точкой атаки: нескольких отравленных документов хватает, чтобы увести ответы модели и обойти защиту.
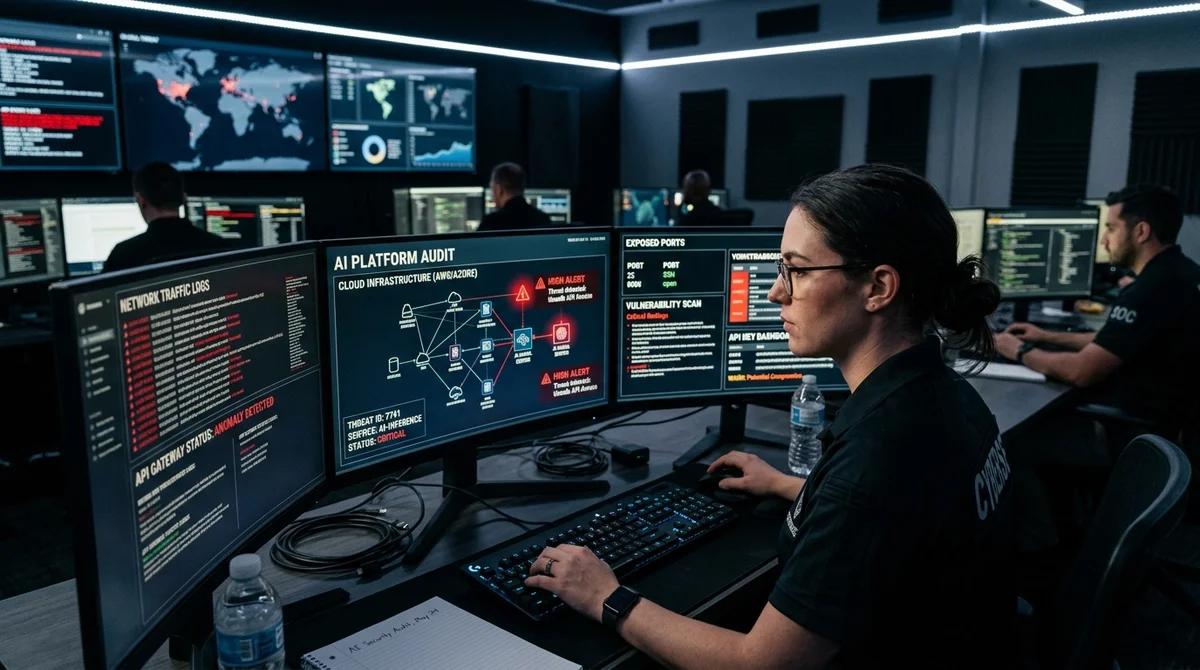
Habr AI разобрал, как один открытый порт в LLM-платформе ведёт к ключам и инфраструктуре
Команда аудита безопасности проверяла RAG-сервис с десятками тысяч пользователей, не пробила сложные цепочки атак, но через открытый порт получила доступ к ключам и инфраструктуре.
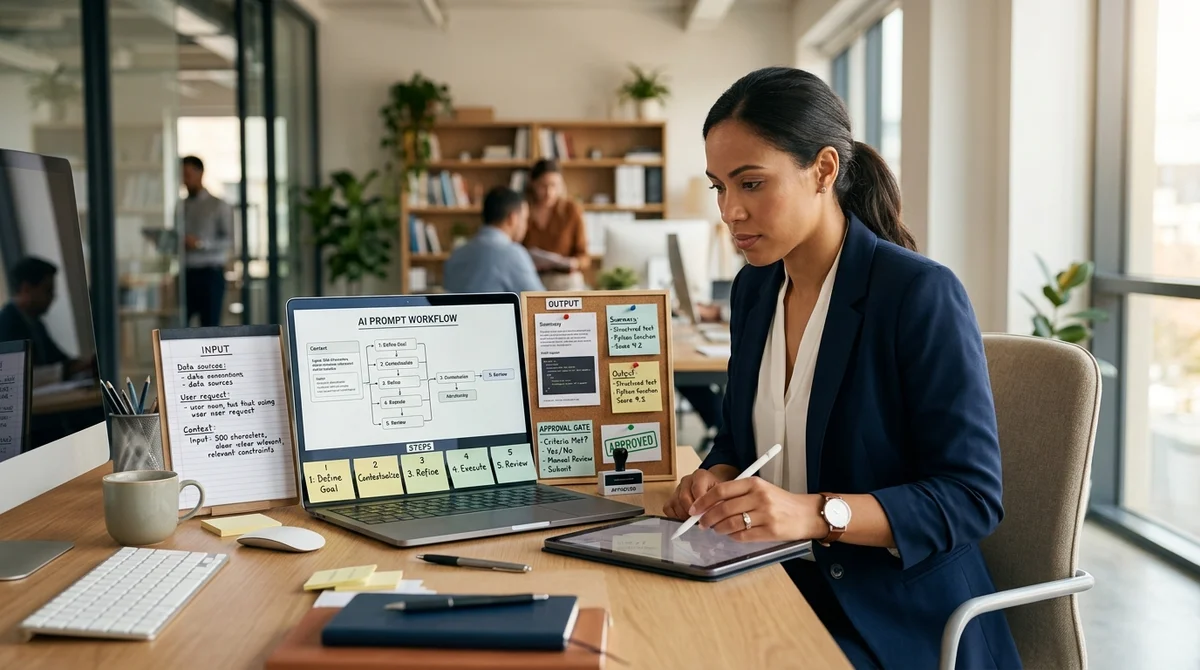
Anthropic Claude не спасает от плохого ТЗ: почему AI выдает убедительный, но слабый результат
На примере Claude автор показывает, что AI чаще ускоряет выпуск правдоподобных ответов, чем полезного результата, если задача не разложена на вход, этапы, выход и критерии приемки.
Как российский разработчик несколько дней запускал Gemini — и что наконец сработало
Российский программист потратил несколько дней на запуск Gemini из России через VPN, перепробовал десятки вариантов и задокументировал каждый шаг — что не работало и что в итоге помогло.
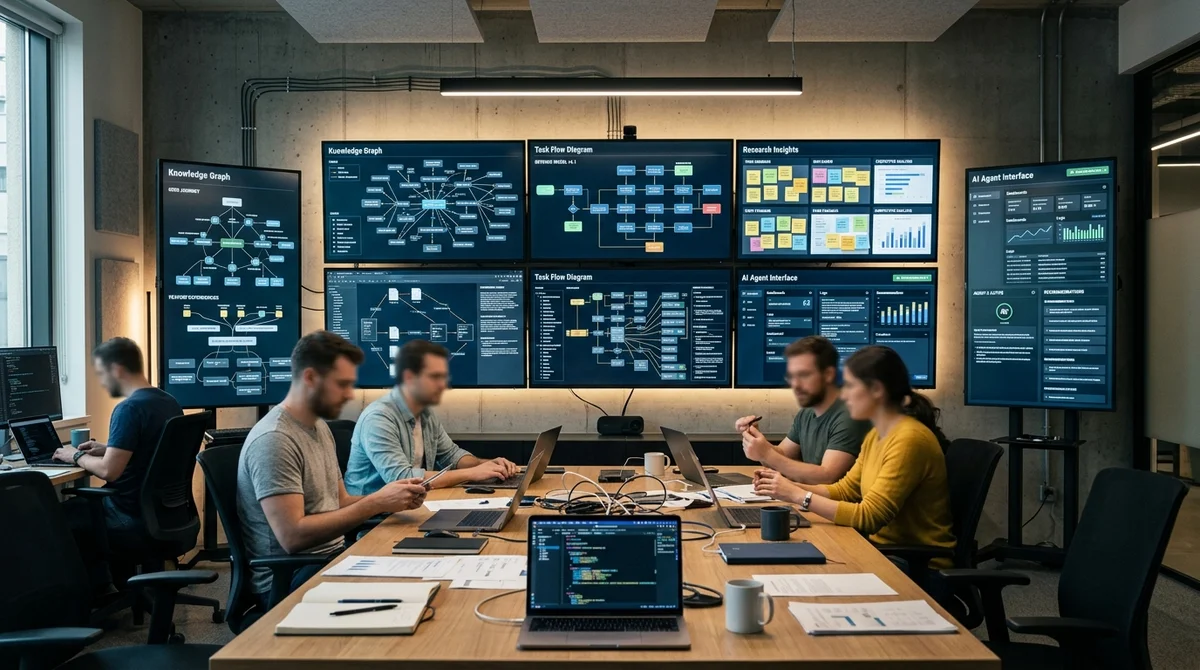
Product Graph и память агентов: почему ИИ не спасает продукт без структуры знаний
Разбор о Product Graph объясняет, почему даже сильные ИИ-агенты бесполезны без общей памяти продукта и как связанная структура знаний снижает хаос в командах.
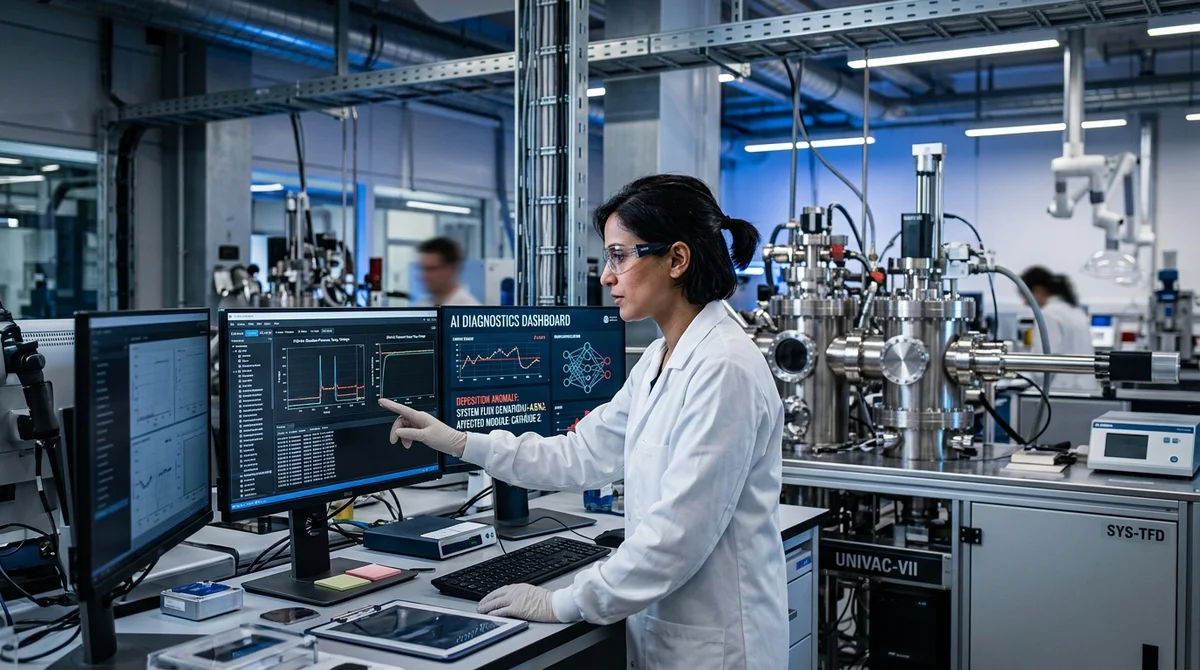
Лаборатория за шесть лет: от флешек и тетрадей до AI, который находит скрытые дефекты
История о том, как одна лаборатория шесть лет строила цифровую инфраструктуру — и в итоге получила AI, который читает логи напыления и заранее находит скрытые дефекты оборудования.
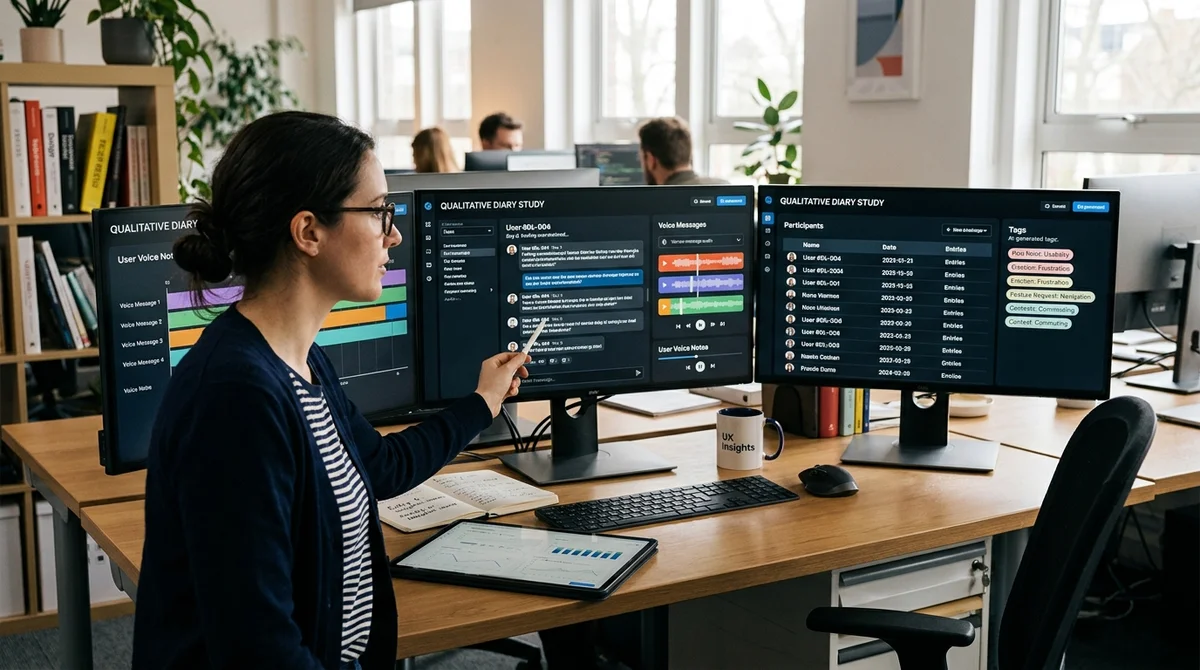
Как AI изменил дневниковое исследование: три компромисса, от которых отказались
Команда UX-исследователей объяснила, как AI позволил отказаться от компромиссов с выборкой, длительностью и глубиной анализа — без урезания ценности метода.
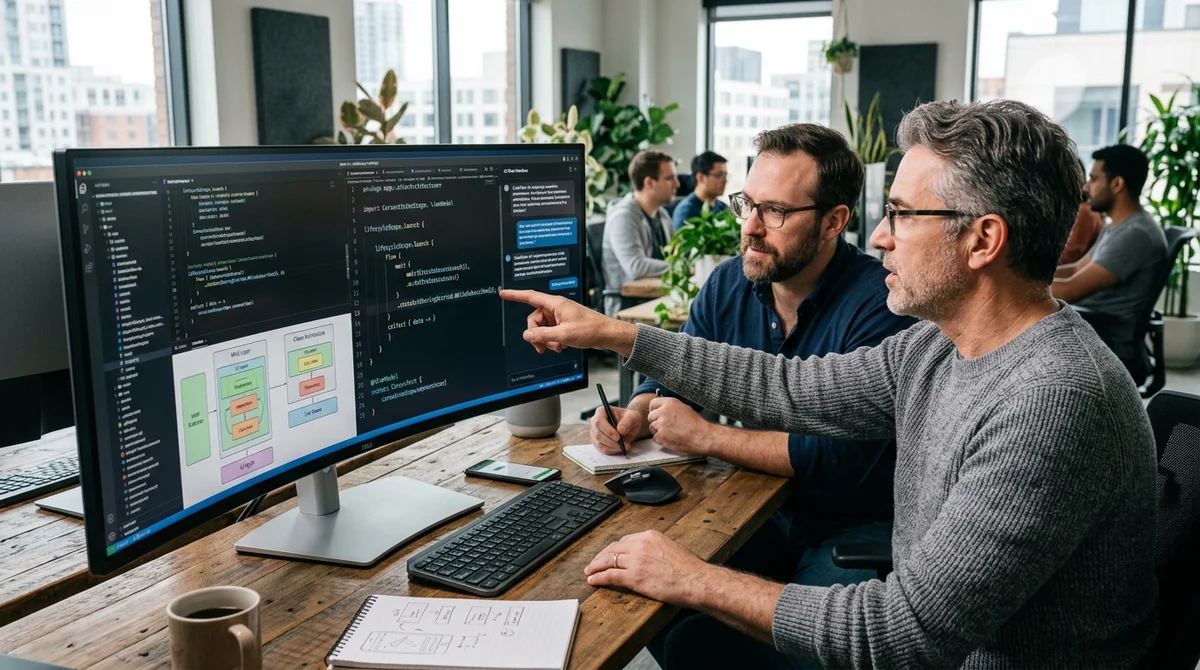
Марчин Москала разобрал GeminiAI: что аудит показал о корутинах и архитектуре Android
Автор open-source клиента GeminiAI рассказал, как его проект прошёл аудит у Марчина Москалы и почему именно ошибки в корутинах стали главным тестом зрелости Android-архитектуры.
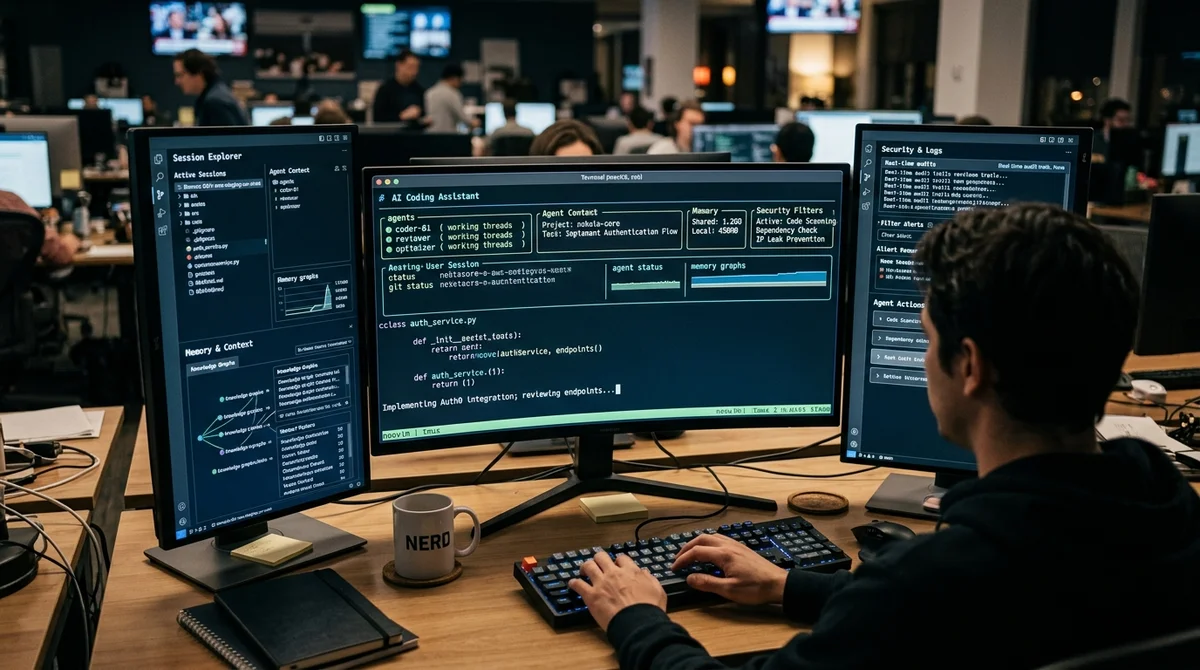
Anthropic: утечка исходников Claude Code раскрыла сложную агентную архитектуру
Утекший через sourcemap код Claude Code показал, что продукт Anthropic давно вырос из «CLI для чата» в платформу с субагентами, памятью, remote-режимами и жёсткой shell-безопасностью.
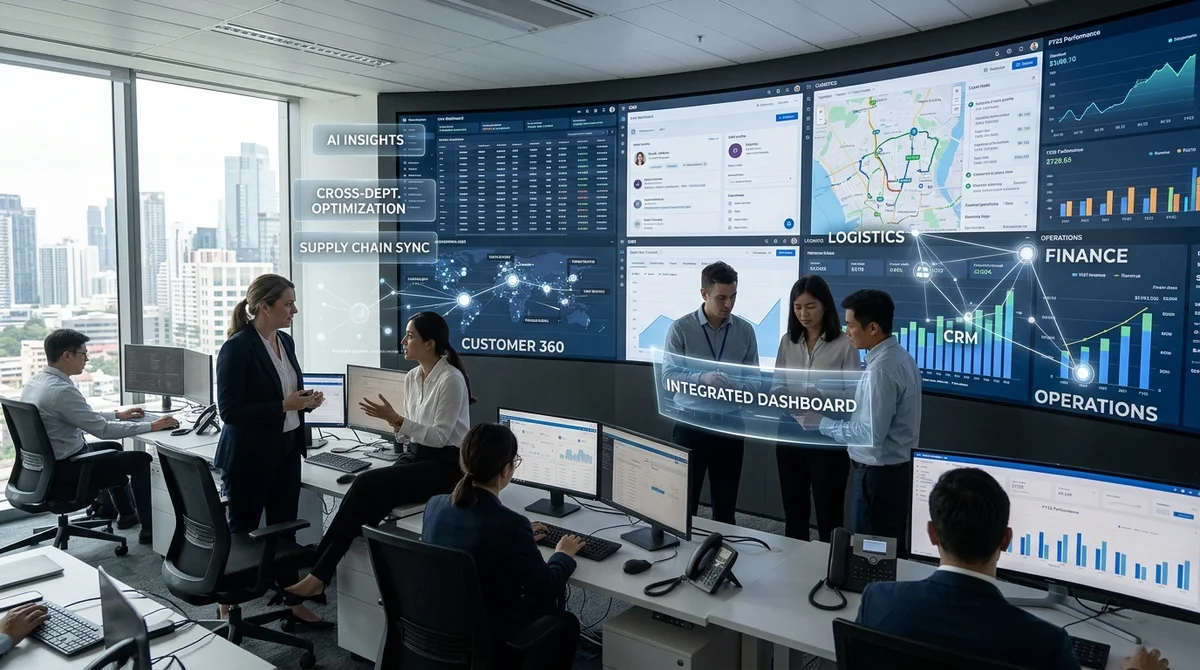
Сбер объяснил, почему бизнесу нужен слой AI Overlay вместо перестройки отделов
Сбер показал, почему точечное внедрение генеративного ИИ редко приносит прибыль, и предложил альтернативу — горизонтальный слой AI Overlay поверх процессов, данных и корпоративных систем.
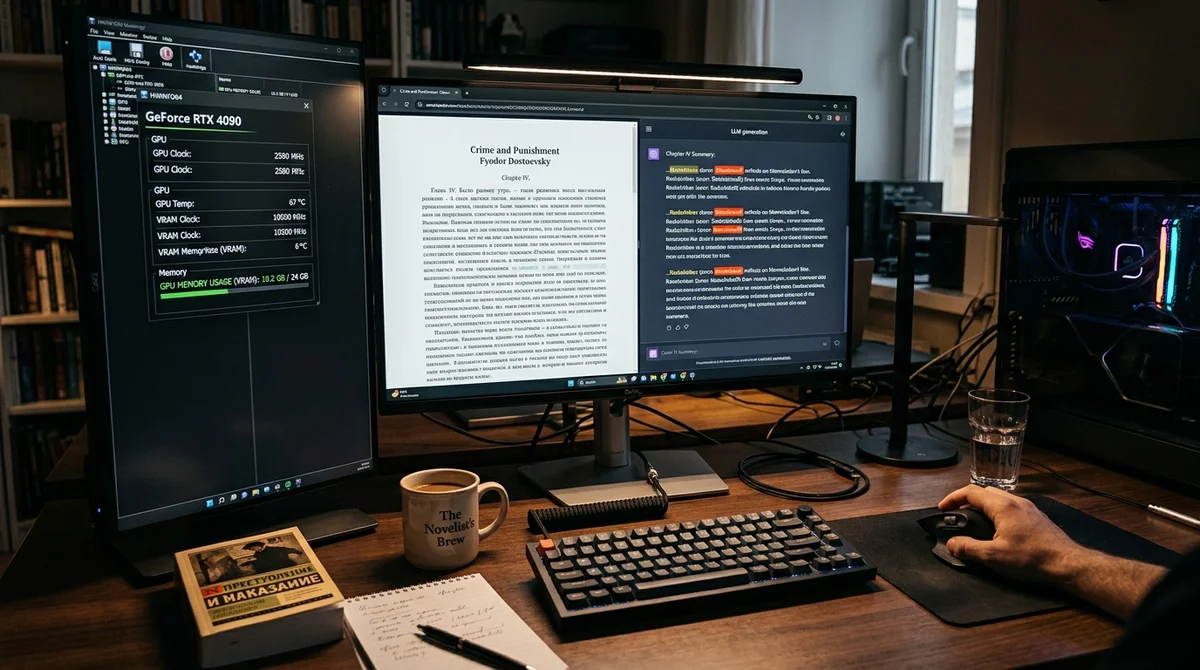
Saiga Llama 3 8B на 10 ГБ VRAM: как на Habr добились 93% точности по «Войне и миру»
На Habr AI показали, как запустить Saiga Llama 3 8B на 10 ГБ VRAM, сжать два тома «Войны и мира» в саммари и снизить число галлюцинаций жёстким промптом и постобработкой.
4 паттерна нетехнических фаундеров, из-за которых стартап не взлетит
Разработчик с Хабра поработал с несколькими нетехническими фаундерами и описал четыре паттерна, из-за которых стартапы не запускаются — и как AI делает эти паттерны ещё опаснее.
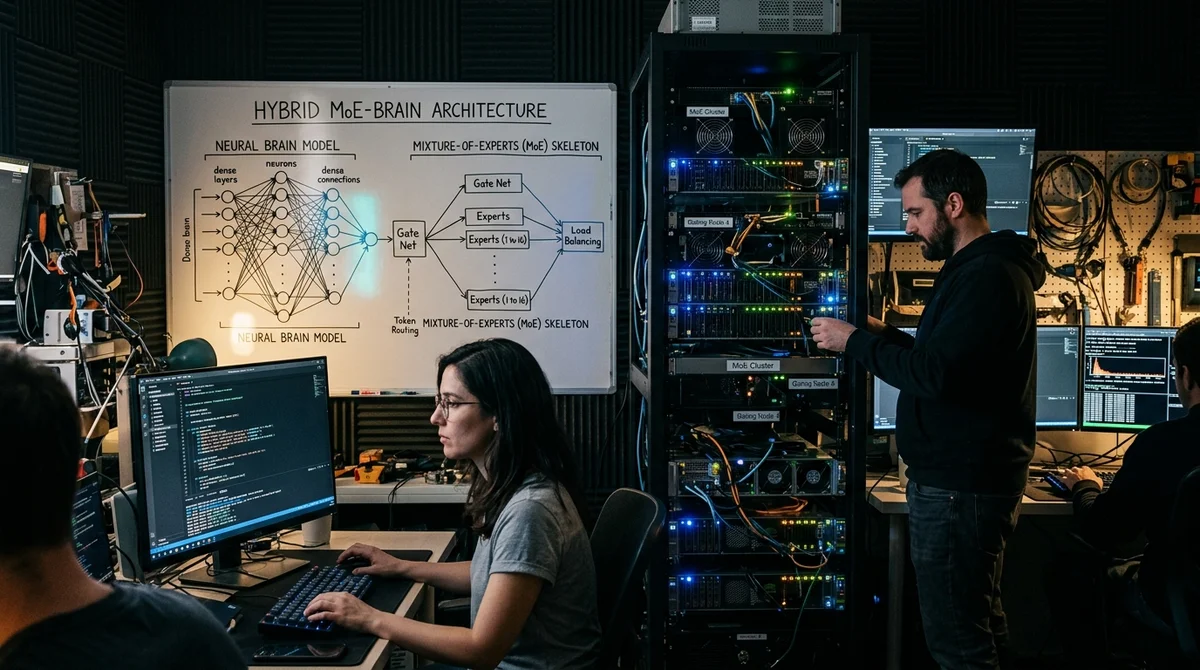
DeepSeek и Gemma: как эксперимент с гибридной LLM на Kaggle сломал библиотеку Transformers
Энтузиасты перенесли четыре 31B-слоя Gemma в MoE-архитектуру DeepSeek без дообучения, обошли ограничения PyTorch и Transformers и запустили хаотичную, но живую LLM-химеру.
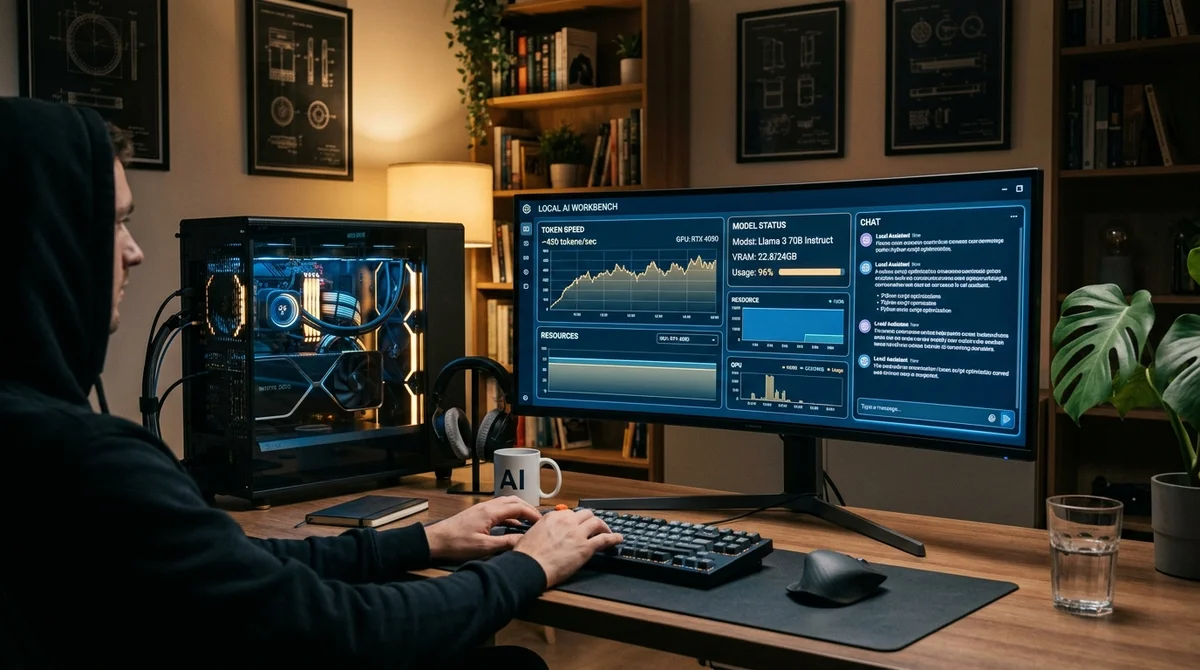
Google Gemma 4 и Qwen 3.6 возглавили список лучших локальных моделей для дома в 2026 году
Подборка локальных моделей 2026 года показывает, что для домашнего AI уже хватает RTX 3060, а выбирать нужно по VRAM, квантованию и задаче — от кода до транскрибации.
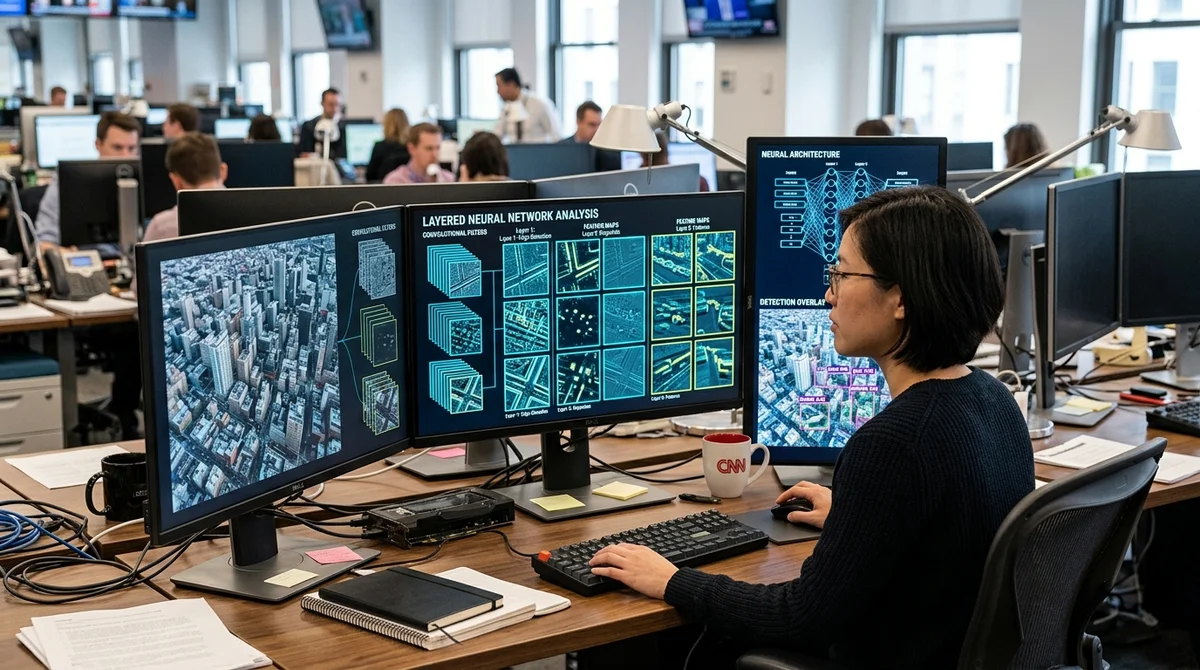
Яндекс Практикум показал, как CNN видят изображения и почему параметры решают не всё
На Habr AI вышел разбор от Яндекс Практикума о том, как свёрточные нейросети обрабатывают изображения, почему архитектура важнее голого размера модели и кому это полезно.
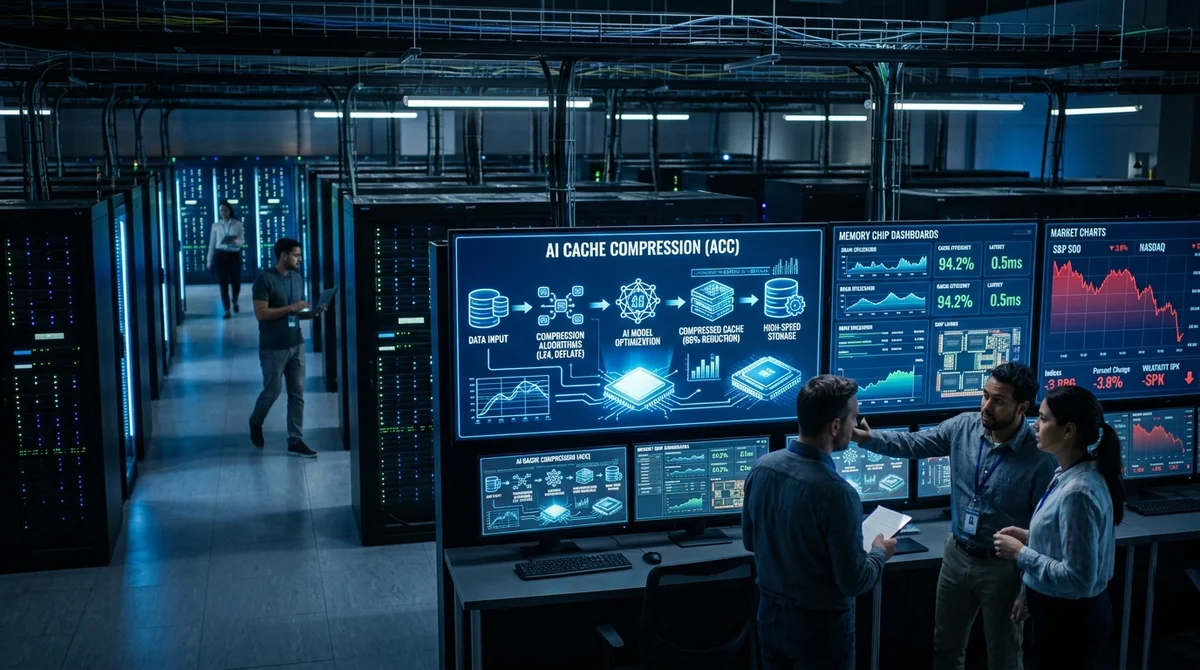
Google показала TurboQuant: 3-битный KV-кэш для LLM, но рынок памяти запаниковал рано
После анонса TurboQuant акции производителей памяти просели, но за громким эффектом скрываются ограничения: кода нет, интеграции нет, а научный спор только разгорается.
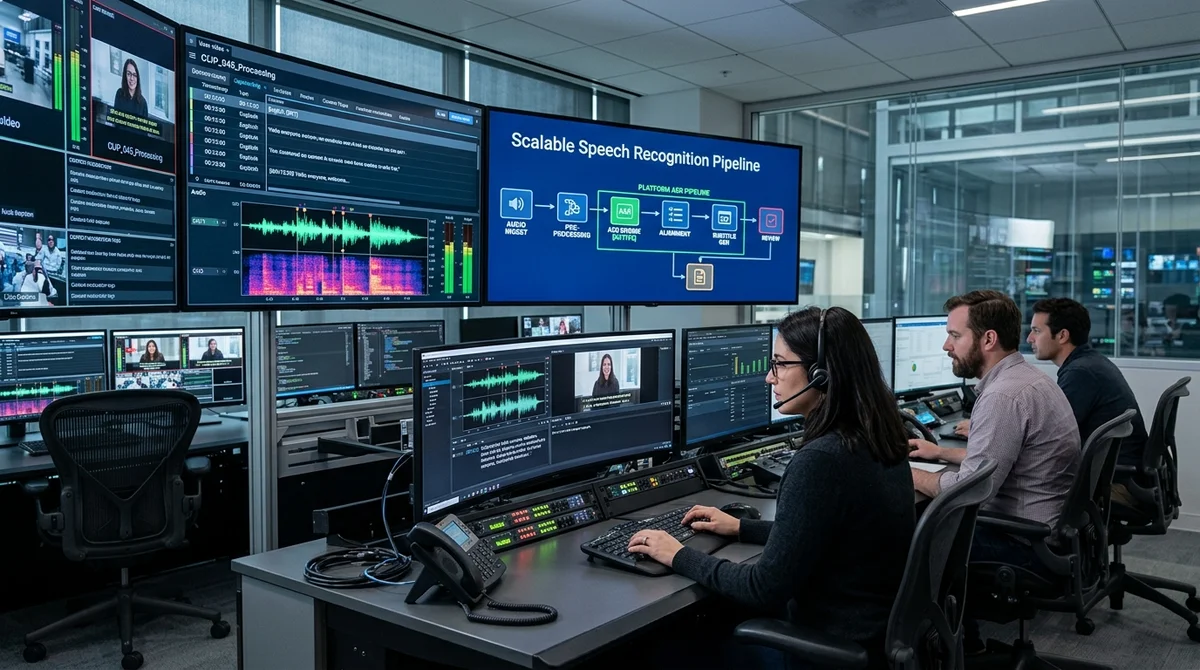
Rutube перешёл от пилота на Whisper к собственной платформе субтитров и распознаванию речи
Rutube рассказал, как превратил быстрый пилот на Whisper в полноценную платформу субтитров с микросервисной архитектурой и собственной ASR, обрабатывающей до 1200 видео в час.
Raft показала, как компаниям оценивать AI-агентов до запуска в рабочих процессах
Raft выпустила практическое руководство по evals для AI-агентов: вместо интуиции и разовых демо компаниям предлагают проверять результат, путь и цену ошибок.
Veai показала, как тестирует ИИ-агента в JetBrains IDE без зависимости от модели
Veai описала подход к UI-автоматизации плагина для JetBrains IDE: команда отделила детерминированный интерфейс от ответов LLM и сократила ложные падения тестов.