Локальные LLM
Локальные LLM — это языковые модели, которые работают прямо на вашем железе: ноутбуке, ПК с видеокартой или домашнем сервере — без облака, подписок и передачи данных наружу. Ollama, llama.cpp и LM Studio плюс квантованные GGUF-версии Llama, Qwen и Gemma делают это доступным даже на видеокарте десятилетней давности. Здесь — все наши материалы о локальном запуске ИИ: гайды, тесты железа, квантизация и приватность.
OpenClaw запустили на Wiren Board: как AI-агент управляет контроллером и пишет скрипты
Инженер Wiren Board развернул OpenClaw прямо на контроллере, подключил Telegram, обучил агента работать с Modbus и проверил, сможет ли тот писать правила и собирать…
Cursor выпустила TypeScript SDK для coding-агентов с облачными песочницами и оплатой по токенам
Cursor открыла публичную бету TypeScript SDK: теперь разработчики могут запускать coding-агентов локально, в облаке и на своих воркерах — с sandboxed VM, subagents…
Автор Habr AI предложил строить детерминированный ИИ на MacBook Air вместо GPU-гонки
На Habr вышел манифест против гонки GPU: автор утверждает, что детерминированное ИИ-ядро на Rust с логикой O(1) может работать локально на MacBook Air и снижать…
Poolside выпустила Laguna XS.2 и M.1 — открытые модели для агентного программирования
Google Gemma 4 и Qwen 3.6 возглавили список лучших локальных моделей для дома в 2026 году
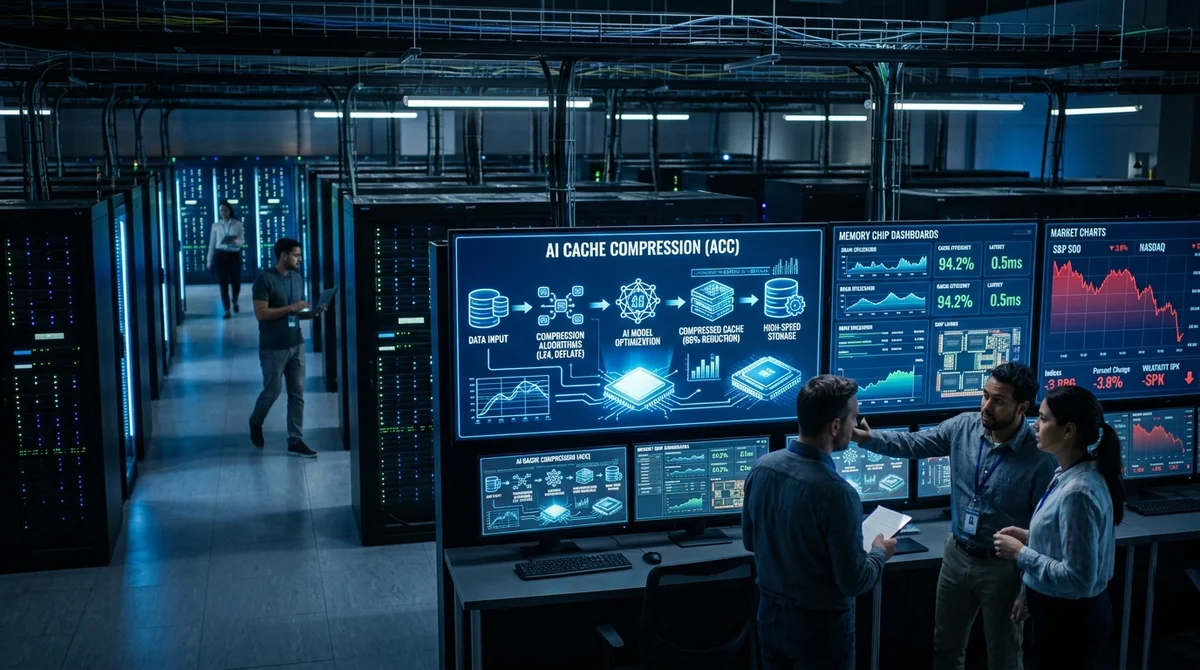
Google показала TurboQuant: 3-битный KV-кэш для LLM, но рынок памяти запаниковал рано
Canonical делает AI в Ubuntu опциональным: курс на локальные модели и контроль пользователя
Whisper и Faster-Whisper: как расшифровывать аудио локально без отправки файлов в облако
Пошаговый разбор локальной транскрибации аудио через Faster-Whisper и Python: данные не уходят в облако, а запуск возможен офлайн как на CPU, так и на GPU.
Nvidia выпустила Nemotron 3 Nano Omni — открытую мультимодальную модель для edge-агентов
Nvidia представила Nemotron 3 Nano Omni — открытую мультимодальную модель с 30 млрд параметров и 3 млрд активных на инференсе, рассчитанную на автономных AI-агентов…
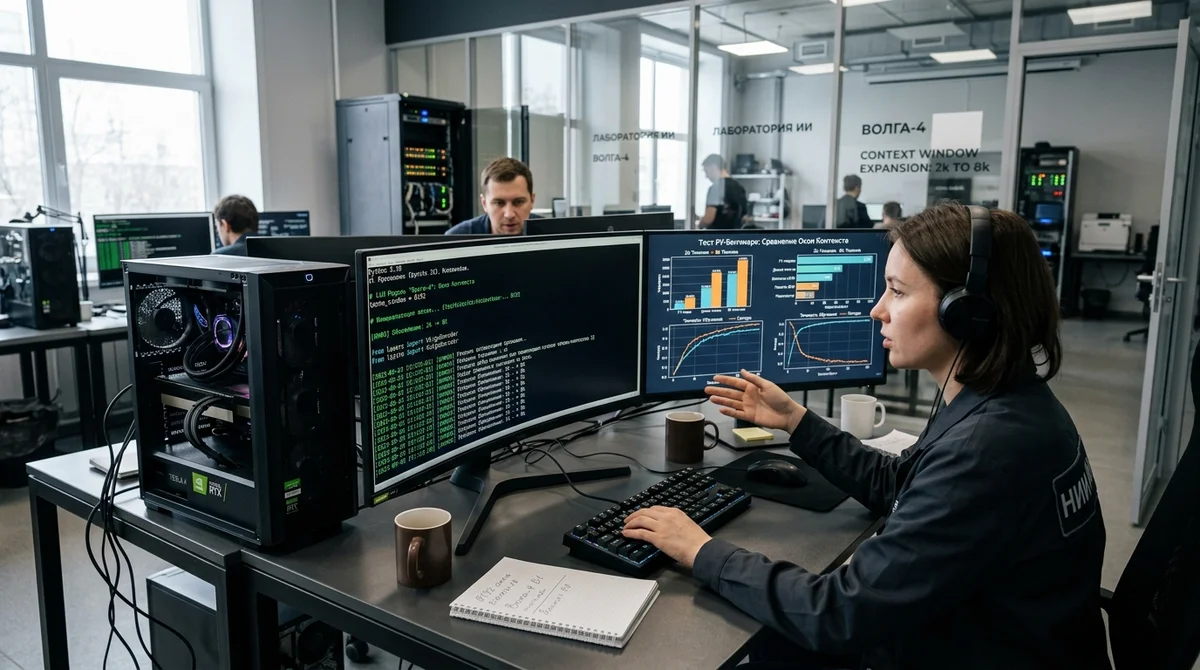
ruGPT3XL получил контекст 8k: восстановленная модель почти без потерь вышла за предел 2k
М2 передала нейросети 40% маркетинговых текстов и не потеряла качество контента
Habr AI показал, как добавить память и контекст в LLM-чат на Python с Ollama и LiteLLM
Google Gemma 4, NVIDIA и OpenClaw: локальные AI-агенты без оплаты за каждый токен
OpenGrall представил архитектуру для роботов с ИИ, где языковая модель отвечает за стратегию
Фреймворк OpenGrall предлагает разделить мышление и управление: LLM отвечает за стратегию, а TinyML — за исполнение и безопасность, снижая задержки даже на слабом…
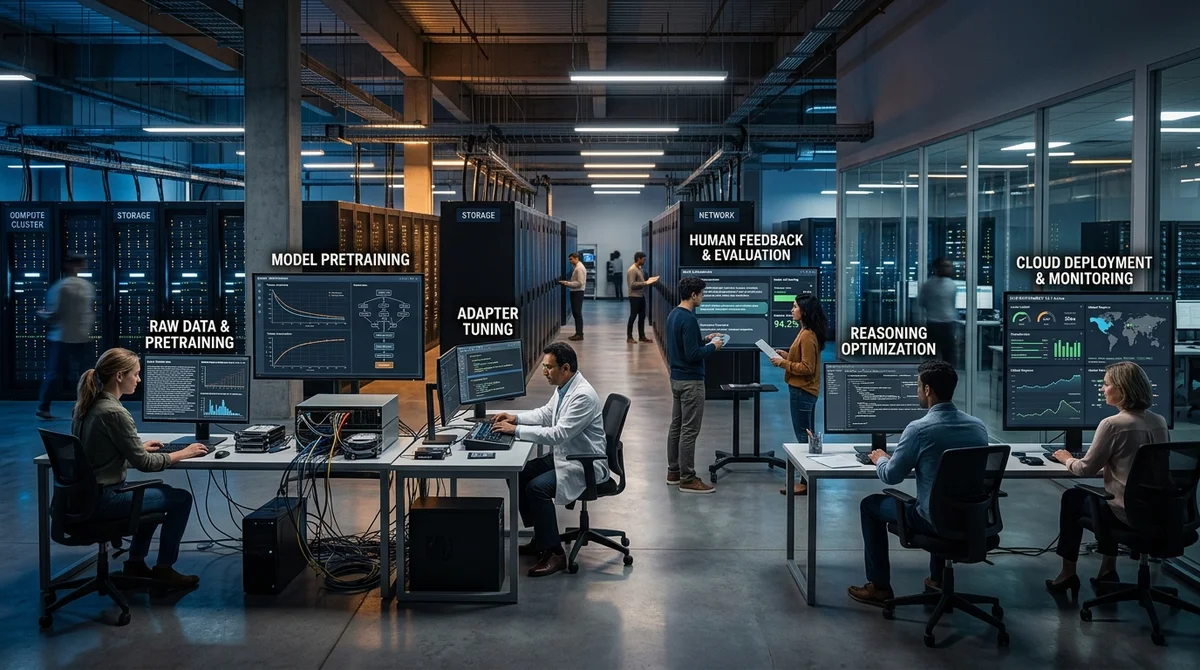
MarkTechPost разобрал полный цикл обучения больших языковых моделей: от данных до деплоя
MarkTechPost выпустил подробный разбор того, как сегодня строят LLM: от предобучения на огромных корпусах до SFT, RLHF, оптимизации логики рассуждений и…