Локальные LLM
Локальные LLM — это языковые модели, которые работают прямо на вашем железе: ноутбуке, ПК с видеокартой или домашнем сервере — без облака, подписок и передачи данных наружу. Ollama, llama.cpp и LM Studio плюс квантованные GGUF-версии Llama, Qwen и Gemma делают это доступным даже на видеокарте десятилетней давности. Здесь — все наши материалы о локальном запуске ИИ: гайды, тесты железа, квантизация и приватность.

Whisper и Gemma 3 связали контрастивным обучением для дешёвого голосового ввода в LLM
Разработчик показал, как связал Whisper и Gemma 3 через MLP-проектор и контрастивное обучение: после серии неудачных регуляризаций модель снизила WER до 35% и…
Стэнфорд представил OpenJarvis — стек локальных AI-агентов с памятью и обучением
Стэнфорд представил OpenJarvis — платформу для персональных AI-агентов, которые работают прямо на устройстве, используют память и инструменты и учатся на локальных…
Open-source-стек из 6 моделей и 9 агентов показал, как собрать ИИ-команду на одном сервере
Шесть open-source-моделей и девять агентов на одном GPU-сервере образуют автономную AI-команду, которая сама проектирует, пишет, тестирует и деплоит новых агентов.
Mistral выпустила Small 4 — 119-миллиардную MoE-модель для reasoning, кода и мультимодальности
Nvidia превратила OpenClaw в корпоративную платформу с безопасностью и локальными ИИ-моделями
NVIDIA выпустила Nemotron 3 Nano 4B — компактную гибридную модель для запуска на устройствах
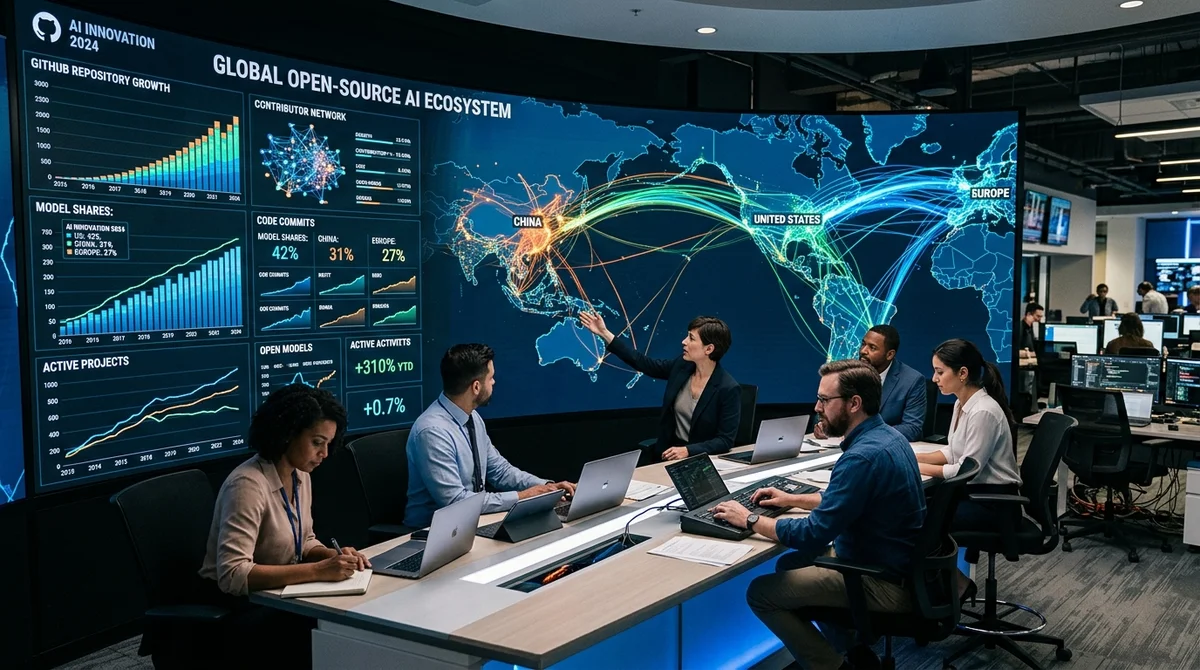
Hugging Face: китайские open-source модели обошли США по загрузкам в экосистеме ИИ
Дженсен Хуанг из Nvidia назвал OpenClaw «следующим ChatGPT» для эпохи ИИ-агентов
Глава Nvidia считает, что OpenClaw может стать таким же переломным продуктом для автономных ИИ-агентов, каким ChatGPT стал для массового рынка чат-ботов.
Ollama и LiteLLM: на Habr показали, как запустить локальный LLM-чат на Python без облака
На Habr вышел практический гайд для новичков: автор показывает, как развернуть локальную модель через Ollama, подключить её к Python через LiteLLM и получить первый…
Claude и Ollama помогли селлеру Ozon за день обработать сертификаты и вернуть 1000 SKU
Ollama и LiteLLM: как превратить Python-скрипт в полноценный консольный LLM-чат
AI Independence Bench сравнил 49 моделей и измерил их устойчивость к давлению пользователя
Garage Eight: как AI меняет работу аналитиков и почему джун-позиции исчезают
Google представила TurboQuant: 6-кратное сжатие KV-кэша LLM без потери точности
Google Research показала TurboQuant — алгоритм, который сжимает KV-кэш больших языковых моделей минимум в шесть раз и ускоряет attention до 8 раз без просадки…
Doka представила локального AI-агента для России без vpn, подписки и облака
Разработчик упаковал собственного AI-агента в десктопное приложение Doka: сервис работает локально, использует модель Qwen3 и не требует облака, vpn или ежемесячной…